平面内存与分段内存的递归本质:从x86历史到WebAssembly与CHERI的未来
深入探讨平面内存与分段内存的递归关系,剖析x86架构演变、Unix影响、CHERI能力模型以及WebAssembly内存模型,揭示内存安全与硬件设计之间的深层矛盾。
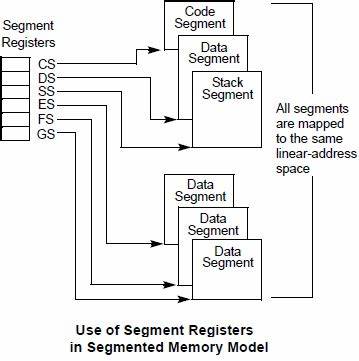
在计算机体系结构的发展长河中,内存模型的演进始终是一个引人入胜的话题。平面内存模型与分段内存模型之间的争论,已经持续了数十年,并且至今仍在以新的形式继续。本文将带领读者深入探讨这两种内存模型的本质差异、它们的历史渊源,以及当代技术如WebAssembly和CHERI如何重新唤起对分段内存模型的兴趣,并揭示一个核心观点:内存的递归细分是软件开发的根本需求,而硬件设计却天然倾向于非递归的有限状态结构。 要理解平面内存与分段内存之争,首先需要回顾x86架构的演变历史。Intel 80286处理器引入了复杂的分段内存系统,这一设计曾经是x86架构的标志性特征。分段内存允许程序将地址空间划分为多个逻辑段,每个段可以有不同的基址和界限,从而实现一定程度的内存保护和隔离。

然而,随着时间的推移,特别是向64位架构迁移的过程中,这种细粒度的内存保护逐渐被削弱。 这种衰退并非偶然,而是有着深刻的历史背景。Unix操作系统的主导地位在此扮演了关键角色。Unix继承了PDP-11乃至PDP-7的设计理念,偏好平面地址空间而非分段地址空间。在Unix的世界观中,程序应该能够自由地在连续的地址空间中操作,而无需关心底层的分段结构。这种哲学深深地影响了后来的操作系统设计,包括Linux和各种类Unix系统。
当业界开始考虑64位扩展时,自然而然地选择了延续平面内存模型,因为没有人真正想要一个64位版本的复杂分段系统。 与此同时,一个有趣的现象正在发生:WebAssembly的兴起让分段内存模型以一种全新的形式回归。WebAssembly的内存模型与传统的平面内存不同,它要求线性内存必须是连续的,但同时通过类型系统和模块边界实现了某种程度的隔离与保护。这种设计让人联想到OS/2或其他非Unix操作系统的编程模型。在WebAssembly的生态系统中,开发者们常常戏称"分段内存正在回归"。 Poul-Henning Kamp曾在其经典文章中,将CHERI架构描述为对平面内存模型的一种反动,他认为平面内存本质上是"任何速度下都不安全"的。

Kamp观察到一个深刻的现象:无论硬件提供什么样的内存模型,软件总会在其上施加某种细分结构。程序员永远不会以完全扁平的方式思考内存使用,他们总是需要将数据组织成层次化的结构。 这引出了一个核心问题:硬件应该在多大程度上了解这种细分结构?传统的x86分段机制试图在硬件层面实现这种细分,但效果并不理想。原因在于x86的分段语义并不足以实现细粒度的安全约束。非特权代码可以重新加载段寄存器,从而访问任何已定义的段,唯一的保护机制是非常粗粒度的四级特权环模型。这意味着传统的分段更多地用于故障隔离而非真正的安全保护:它只在用户态与系统态之间提供区分,但对于同一特权级别内的恶意代码却无能为力。
然而,仅仅将问题视为"硬件是否应该了解细分结构"是一种过于简单的二元对立。更准确的视角是将其视为一个递归现象。当我们在平面内存上施加某种细分结构时,我们很自然地希望再次进行细分。想想内存池或内存区域的设计,再想想结构体中嵌套字段的情况。程序员的心理抽象从来不是真正扁平的,但硬件却是非递归的。硬件本质上是有限状态机,其工程实践倾向于固定的结构和有界深度。
或许一个超CISC的CPU能在微代码中提供一些迭代能力,但这基本上就是极限了。 这种根本性的矛盾 - - 软件的递归性与硬件的非递归性 - - 该如何调和?一种朴素的方法是限制深度:比如硬件只了解最多N层的分解,通常N等于1,其余的由软件负责。但这并不令人满意,因为它相当于"硬件推卸责任",保证了在更高层级上失去硬件可能带来的价值,并且导致了不一致性。 CHERI采用了一种更为巧妙的方法来解决这个问题。它保持了处理递归分解的灵活性,因为软件仍然负责递归步骤:边界可以任意狭窄,但这些边界由软件进行窄化并显式传递。因此,任何时刻能够寻址的内容并不主要由硬件状态决定,而是由软件行为产生的一种涌现 - - 即当前执行代码可达的能力的传递闭包。
这种涌现性自然会带来审计方面的困难,但合适的工具可以应对这一挑战。 CHERI通过一个看似矛盾的限制获得了这种灵活性:寻址被约束为在能力派生操作的不间断链上进行,边界单调递减。这种设计有其深刻的道理,但也带来了一些不适感。因为软件就是软件,某些程序总会选择自己的方式,例如执行一些非单调的地址计算。几十年来,我们积累了大量的程序,它们以自己喜欢的方式表达对某种细分地址空间的遍历。这种传统与任何新的、更具观点性的硬件之间都会产生摩擦。
克服这种摩擦只是开发投入的问题,但要使这种投入变得常态化,或者说使其成本在行业内成功"外部化",CHERI(或类似技术)必须"获胜"。这里的"获胜"指的是实现硬件的普及,这是一个高风险的博弈。 值得一提的是,还有一种完全不同的方法来解决内存细分问题:经典的虚拟机语言方法采用了与硬件相反的极端方式。一切都被近乎最大化地细分成微小的对象,以及它们之间巨大的显式互引用(指针)关系。程序员的脑海中无疑有更粗粒度的结构,但这些结构停留在他们的思维中:系统不提供围绕这些结构组织存储的方式。因此,这些系统也在空间局部性上做出了妥协 - - 空间局部性是硬件将字节或字组合成更大单元的启发式方法,这也是这些方法长期存在性能劣势的原因。
在这场关于内存模型的讨论中,liballocs项目提供了一个独特的视角。它并不关心安全,因此基本上不需要涉足规定地址派生规则的领域。它更关注的是描述性地捕获真实软件可能产生的任何结构,因为它递归地细分了起始的平面地址空间。它的核心是一个递归抽象:分配嵌套在其他分配中,形成一棵树。这里没有"第N层截断"或硬件/软件划分:它从根本上就是软件,并希望使用尽可能统一的反射抽象来捕获从头到尾的所有结构,尽管系统内的实现是多种多样且异构的。这种"同质接口,异构实现"的理念通常与面向对象相关联,而很少与硬件相关。
虽然liballocs本身对程序如何使用其递归细分的结构并不持有观点,但它当然可以用来构建附加的安全机制,对结构的使用施加某些观点 - - 当然,只有在底层硬件提供了在同一地址空间内保护这些机制本身的有用原语时,才能真正抵御恶意行为。令人烦恼的是,x86风格的分段本来可以提供近乎充分的基础,如果操作系统实际将其暴露给用户空间的话。对于我大致想要的东西,我常常想起那篇有趣的论文《x86戒指之王》。 回顾整个内存模型的发展史,我们可以看到几个清晰的趋势。首先,平面内存模型的胜利并非技术上的绝对优势,而是Unix生态系统影响力的结果。其次,软件对内存的递归细分需求是普遍存在的,不受编程范式的影响。
第三,硬件在支持递归结构方面天然存在困难,这是冯诺依曼架构固有的限制。第四,新兴技术如WebAssembly和CHERI正在以不同的方式重新引入分段或细分的概念,试图在保持性能的同时提供更好的安全性。 展望未来,内存模型的发展可能会呈现多元化趋势。传统的平面内存模型不会消失,因为其在通用计算和性能方面的优势仍然显著。但对于特定的应用场景,如WebAssembly这样的沙箱环境,或者需要高级别安全保证的系统,分段或基于能力的内存模型可能会成为主流。CHERI代表的基于能力的内存访问模式提供了一种有前景的中间道路,它既保持了软件的灵活性,又通过硬件原语提供了可验证的安全保证。
最终,平面与分段之争的核心或许不在于选择哪一种,而在于理解软件对内存组织的递归需求,并找到硬件与软件协同工作的最佳方式。无论是通过传统的段寄存器、基于能力的寻址,还是通过新兴的WebAssembly内存模型,我们都在试图解决同一个根本问题:如何在提供安全保护的同时,不牺牲软件开发的自然性和硬件执行的高效性。这场辩论远未结束,它将继续以我们今天难以完全预见的形式塑造未来的计算架构。 。