Lumabri:用P2P蜂群技术运行MoE大模型,突破AI推理瓶颈的创新方案
分享一种革命性的AI推理架构,通过P2P蜂群技术让MoE大模型在多台普通设备上协同运行,无需预下载模型即可实现高效推理,同时保证计算结果的精确性和安全性。
在当前AI技术快速发展的时代,大语言模型(LLM)的推理成本和部署复杂性正成为制约其普及的关键因素。动辄数百GB的模型参数,不仅需要高端GPU服务器,还需要大量的存储空间和网络带宽。传统的集中式推理方式不仅成本高昂,还存在单点故障风险。正是在这种情况下,一种名为Lumabri的P2P蜂群推理系统横空出世,为MoE(Mixture-of-Experts)大模型的分布式推理提供了全新的解决方案。Lumabri是一个纯C语言编写的开源项目,基于Colibri引擎构建,专门用于在P2P网络中运行MoE架构的大模型。它颠覆了传统的集中式推理模式,通过将模型分片存储在多个节点上,实现了去中心化的推理协作。

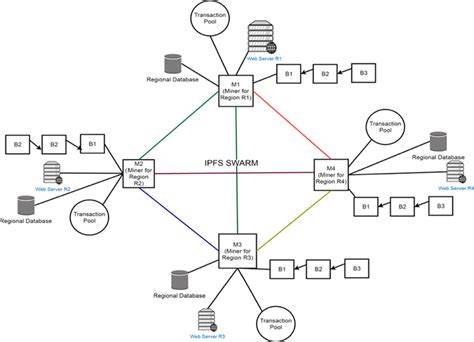
无论是CPU还是GPU设备,都可以加入这个蜂群网络,共同为用户提供推理服务。最引人注目的是,Lumabri不需要预先下载整个模型,只需要在推理时动态获取所需的模型片段,极大地降低了入门门槛和存储成本。**从集中式到分布式:AI推理的范式转变**传统的AI推理系统通常采用集中式架构,模型存储在单个服务器上,所有推理请求都发送到这台服务器进行处理。这种方式的优势在于管理简单,但缺点也非常明显:高昂的硬件成本、单点故障风险、网络带宽瓶颈以及扩展性差。特别是对于MoE模型来说,其巨大的参数规模使得集中式部署变得极其困难。Lumabri采用了完全不同的P2P蜂群架构,将模型分布式存储在多个节点上。
每个节点可以是一台普通的PC、服务器,甚至是带有SSD的嵌入式设备。当用户发起推理请求时,系统会根据模型的结构,将请求路由到拥有相关模型分片的节点上进行处理。这种架构的优势在于:首先,它极大地降低了硬件成本。用户无需购买昂贵的GPU服务器,只需要一台普通的PC或笔记本电脑即可加入蜂群网络,贡献自己的存储空间或计算能力。其次,它提高了系统的容错能力。即使部分节点离线,其他节点仍然可以继续提供服务,确保推理过程不中断。

最后,它实现了真正的去中心化,避免了单点故障的风险,提高了系统的可靠性。**动态模型加载:无需预下载,按需获取**Lumabri的一个核心创新在于其动态模型加载机制。传统的推理系统需要将整个模型加载到内存中,这对于MoE模型来说几乎是不可能的任务。而Lumabri采用了一种名为"稀疏镜像"的技术,将模型文件以稀疏文件的形式存储在本地,只有在推理过程中实际需要的模型片段才会被动态获取。具体来说,当用户发起推理请求时,Lumabri会通过P2P网络动态获取所需的模型分片,并将其存储在本地的稀疏镜像中。这种机制具有以下优势:首先,它极大地节省了存储空间。
用户无需预先下载整个模型,只需要存储推理过程中实际使用的部分。其次,它提高了推理的灵活性。用户可以随时切换不同的模型,而无需重新下载整个模型文件。最后,它实现了真正的按需加载,只有在推理过程中实际需要的模型片段才会被获取,极大地提高了系统的效率。**MoE模型的P2P协作推理**MoE模型的核心在于其稀疏激活机制,即在推理过程中,只有部分专家(experts)会被激活。这种特性使得MoE模型非常适合P2P分布式推理。
Lumabri充分利用了这一特性,将MoE模型的推理过程分解为多个子任务,每个子任务由蜂群网络中的不同节点负责。具体来说,Lumabri将MoE模型的推理过程分为两个阶段:预填充阶段和目标推理阶段。在预填充阶段,用户节点(即发起推理请求的节点)会将输入数据发送到蜂群网络中,由拥有相关模型分片的节点进行处理。在目标推理阶段,系统会根据预填充的结果,将推理请求路由到拥有相关专家的节点上进行处理。这种架构的优势在于,它将MoE模型的推理过程分解为多个独立的子任务,每个子任务可以由不同的节点负责。这样不仅提高了系统的并行性,还实现了真正的分布式推理。
此外,由于每个节点只需要存储和处理部分模型分片,极大地降低了硬件成本和存储需求。**安全性与验证:确保推理结果的准确性**在P2P网络中,安全性和验证是至关重要的。Lumabri采用了多种机制来确保推理结果的准确性和安全性。首先,它使用了内容寻址存储(CAS)技术,确保每个模型分片的完整性。每个模型分片都会被计算SHA256哈希值,并存储在本地的内容寻址存储中。这样,即使部分节点提供了错误的模型分片,系统也能够通过哈希值验证其完整性,并从其他节点获取正确的分片。
其次,Lumabri采用了双重验证机制。在推理过程中,系统会将部分推理请求发送到多个节点进行处理,并比较结果的一致性。如果发现不一致的结果,系统会自动切换到其他节点进行处理,确保推理结果的准确性。此外,Lumabri还支持加密传输,确保推理过程中数据的安全性。最后,Lumabri采用了端到端的验证机制。每个节点在加入蜂群网络时,都需要提供其公钥和签名,确保节点的身份和完整性。
这样,即使部分节点被恶意攻击者控制,系统也能够通过验证机制识别并排除这些节点,确保推理过程的安全性。**实用指南:如何部署和使用Lumabri**对于想要尝试Lumabri的用户来说,部署和使用过程相对简单。首先,用户需要下载Lumabri的源代码,并使用GCC编译器进行编译。由于Lumabri是纯C语言编写的项目,编译过程相对简单,无需复杂的依赖管理。编译完成后,用户可以选择两种角色加入蜂群网络:模型持有者(model holder)或推理请求者(inference requester)。模型持有者负责存储和提供模型分片,而推理请求者负责发起推理请求并获取推理结果。
对于模型持有者来说,只需要运行以下命令即可启动服务:bash./lumabri serve --model /path/to/model```对于推理请求者来说,只需要运行以下命令即可加入蜂群网络并发起推理请求:```bash./lumabri chat --tracker <server-ip>:7300 --engines-dir /path/to/colibri/c```在推理过程中,用户可以通过终端界面与系统进行交互。系统会自动管理模型分片的获取和推理过程,用户无需关心具体的实现细节。此外,Lumabri还提供了丰富的命令行选项,用户可以根据需要进行配置和调优。**性能优化与扩展性**Lumabri在设计之初就充分考虑了性能优化和扩展性。首先,它采用了异步I/O机制,确保推理过程不受网络延迟的影响。其次,它支持多种推理引擎,包括OLMoE、GLM、Inkling、Kimi K3和DeepSeek V4等,用户可以根据需要选择合适的引擎进行推理。
此外,Lumabri还支持多种优化策略,例如预取策略(prefetch policy)、对冲策略(hedge strategy)和故障转移策略(failover strategy)。这些策略可以根据网络条件和节点性能进行动态调整,确保推理过程的高效性和可靠性。对于大规模部署来说,Lumabri还支持多种扩展机制,例如分层缓存(hierarchical caching)、负载均衡(load balancing)和动态路由(dynamic routing)。这些机制可以确保系统在大规模部署时仍然保持高效和稳定。**与现有技术的对比**与现有的P2P推理系统相比,Lumabri具有以下独特优势:首先,现有的P2P推理系统通常将Transformer层分割到不同的设备上,这需要每个设备都能快速运行推理任务,在实际应用中通常需要GPU支持。而Lumabri采用了专家级粒度的分割方式,只需要传输4KB的激活数据,使得普通设备也能参与推理过程。
其次,现有的P2P推理系统通常无法保证推理结果的精确性,因为不同设备上的推理结果可能存在差异。而Lumabri通过双重验证机制和端到端验证机制,确保推理结果的准确性和一致性。最后,现有的P2P推理系统通常缺乏安全性保障,容易受到恶意节点的攻击。而Lumabri通过内容寻址存储、双重验证和端到端验证等机制,确保系统的安全性和可靠性。**未来展望:构建去中心化的AI生态**Lumabri的出现不仅为MoE大模型的推理提供了全新的解决方案,还为构建去中心化的AI生态奠定了基础。随着更多用户加入Lumabri蜂群网络,我们可以期待一个真正去中心化、高效、安全的AI推理平台的诞生。
未来,Lumabri可能会在以下几个方面进行进一步的优化和扩展:首先,支持更多的MoE模型和推理引擎,为用户提供更多的选择。其次,优化P2P网络的路由算法,提高推理过程的效率和可靠性。最后,引入更多的安全机制,例如自动密钥轮换、分布式密钥管理等,确保系统的安全性和可扩展性。总之,Lumabri代表了AI推理技术的一次重要创新,为构建去中心化的AI生态提供了强有力的支持。随着技术的不断发展和完善,我们有理由相信,Lumabri将在未来的AI推理领域发挥越来越重要的作用。 。