人工智能代理开发进展缓慢:测量软件性能的误区与行业反思
探讨人工智能代理开发进展的挑战,分析以代码行数衡量软件性能的局限性,并结合Goodhart定律等理论,为技术评估提供更科学的视角。
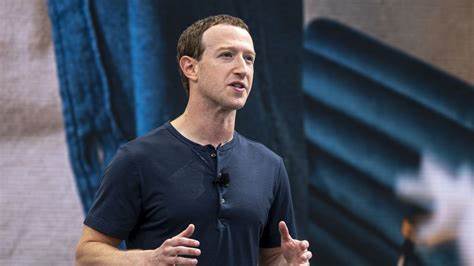
近期,Meta创始人扎克伯格在公开场合提到,人工智能代理的开发进展比预期要慢。这一言论引发了行业内外的广泛讨论。在Hacker News等技术社区中,关于如何评估AI开发进度的争论尤为激烈。其中,一位用户noosphr的评论引发了深刻的思考:将软件性能与代码行数挂钩,就像用飞机重量来衡量其性能一样荒谬。这一比喻虽然极端,却道出了当前技术评估体系中的一个普遍误区。 在软件开发领域,代码行数(SLOC)曾被广泛用作衡量工程师生产力的指标。

然而,这一指标的局限性早已被行业内人士所诟病。代码行数并不能直接反映软件的质量、可维护性或实际价值。例如,一个高效的算法可能只需要几行代码,而一个低效的实现可能需要成千上万行代码。类似地,在人工智能代理的开发中,代码行数更无法准确反映模型的智能水平或实际应用效果。 Hacker News用户Tenoke的回应指出,虽然代码行数并非完美指标,但作为生产量的粗略代理仍有一定参考价值。例如,波音公司生产的飞机总重量可以间接反映其生产规模。
然而,noosphr的反驳揭示了更深层次的问题:当技术评估体系过度依赖单一指标时,可能会导致行业陷入短视和低效的恶性循环。 这一争论背后,实际上涉及到Goodhart定律的经典问题。Goodhart定律指出,当一个指标被用作目标时,它就不再是一个好的指标。在软件开发中,如果过度追求代码行数,可能会导致开发者写出冗余、低效的代码,反而损害了软件的整体质量。类似地,在人工智能领域,如果仅以模型参数量或训练数据量作为评估标准,可能会忽视更重要的因素,如模型的泛化能力、安全性和实际应用价值。 Hacker News用户entrope的评论进一步补充了这一观点。

他指出,AI代理生成的输出虽然看似流畅,但可能存在大量缺陷。这表明当前的质量控制机制可能不足。在技术评估中,必须综合考虑多个维度,而不仅仅依赖单一指标。例如,在评估AI代理的性能时,应结合准确率、鲁棒性、用户体验等多个指标,而不仅仅关注代码行数或模型参数量。 人工智能代理的开发进展缓慢,不仅仅是技术挑战的体现,更反映了行业在评估体系上的不足。当前,许多企业仍在沿用传统的软件开发评估方法,而忽视了AI技术的特殊性。
例如,AI模型的训练和优化过程与传统软件开发有着本质的不同,需要更复杂的评估框架。 在未来,行业需要建立更科学的评估体系,以更好地指导人工智能的发展。例如,可以借鉴机器学习中的A/B测试方法,通过实验数据来验证模型的实际效果。同时,也可以引入更多的质量控制机制,确保AI代理的输出符合安全和伦理标准。此外,行业还需要加强跨学科合作,结合计算机科学、心理学、伦理学等多个领域的知识,以全面评估AI技术的影响。 总结来看,人工智能代理的开发进展缓慢,既是技术挑战的体现,也是评估体系不足的反映。
行业需要重新审视当前的评估方法,建立更科学、更全面的评估框架。只有这样,才能更好地推动人工智能技术的发展,并确保其对社会的积极影响。 。