Fable与10大语言模型在LangGraph代码重构任务中的表现对比
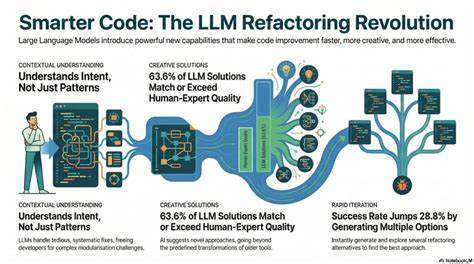
本文深入分析了Fable、GPT-5.4、GPT-5.5等11款语言模型在LangGraph代码重构任务中的表现,探讨了它们在生成建议和评估建议方面的优劣,为开发者提供了选择LLM工具的参考依据。
在人工智能领域,代码重构是一个至关重要的环节。随着LangGraph等框架的普及,如何高效地重构复杂的代码结构成为开发者面临的重要挑战。近期,一项关于Fable与10款其他语言模型在LangGraph代码重构任务中的表现对比研究引起了广泛关注。本文将详细探讨这一研究的背景、方法以及结果,为开发者提供选择合适LLM工具的参考依据。 在软件开发中,代码重构是一个持续优化代码结构和可读性的过程。随着LangGraph等框架的普及,开发者需要处理越来越复杂的代码结构。

然而,传统的代码重构方法往往依赖于人工经验,效率较低。语言模型(LLM)的出现为代码重构提供了新的可能性。通过分析Fable与其他10款语言模型在LangGraph代码重构任务中的表现,我们可以更好地理解这些模型的优势和局限性。 本次研究选择了Fable、GPT-5.4、GPT-5.5、DeepSeek-4-pro、Gemini-3.1-pro、GLM-5.1、Kimi-2.6、MiMo-2.5-pro、Opus-4.7、Qwen-3.6-plus和Qwen-3.7-max等11款语言模型。研究分为三个阶段:首先,每个模型生成自己的重构建议;其次,模型们互相评估彼此的建议;最后,通过多种方法综合评估模型的表现。 在第一阶段,每个模型根据给定的LangGraph代码结构,提出了各自的重构建议。
Fable-5提出了一个平衡的五阶段方案,将逻辑分为tick、prepare、select、decide和guard五个阶段。GPT-5.4和GPT-5.5的方案与Fable-5类似,但GPT-5.5更详细地提取了循环的书记逻辑。DeepSeek-4-pro则采用了更紧凑的四阶段方案,而Gemini-3.1-pro的方案则更加粗粒度。其他模型如GLM-5.1、Kimi-2.6、MiMo-2.5-pro、Opus-4.7、Qwen-3.6-plus和Qwen-3.7-max也提出了各自的重构方案,展现了不同的代码重构策略。 在第二阶段,每个模型评估了其他模型的重构建议。Fable-5的评估报告最为全面,不仅发现了Kimi-2.6和Qwen-3.7-max中的两个实际影响选择的错误,还提供了具体的执行顺序建议。

GPT-5.4则关注了测试迁移的实际性,而GPT-5.5则更注重约束条件的处理。DeepSeek-4-pro的评估报告信息密度最大,但其结论存在问题。Gemini-3.1-pro的评估报告最为简洁,但缺乏具体评估。其他模型的评估报告也各有特色,展现了不同的评估方法。 在第三阶段,研究者通过多种方法综合评估了模型的表现。首先,通过比较模型的平均评分,发现Fable-5的建议获得了最高的平均分,其次是GPT-5.4和GPT-5.5。
其次,通过分析评估报告中的论点,发现Fable-5和GPT-5.5的评估报告最为全面和准确。最后,通过计算模型的预测能力,发现GPT-5.5是最佳的预测者。 本次研究表明,Fable-5在生成建议和评估建议方面表现最为出色。其评估报告不仅全面,还发现了实际影响选择的错误,为开发者提供了具体的执行顺序建议。GPT-5.4和GPT-5.5也表现出色,但Fable-5的评估报告更为全面和准确。DeepSeek-4-pro的评估报告信息密度最大,但其结论存在问题。
Gemini-3.1-pro的评估报告最为简洁,但缺乏具体评估。其他模型的评估报告也各有特色,展现了不同的评估方法。 在选择LLM工具时,开发者需要根据具体需求进行选择。如果需要全面的评估报告和具体的执行顺序建议,Fable-5是最佳选择。如果需要更简洁的评估报告,GPT-5.4和GPT-5.5也是不错的选择。如果需要信息密度最大的评估报告,DeepSeek-4-pro也是一个不错的选择。
然而,需要注意的是,DeepSeek-4-pro的结论存在问题,开发者在使用时需要谨慎。 本次研究为开发者提供了选择LLM工具的参考依据。随着语言模型的不断发展,未来的研究可以进一步探讨如何利用语言模型提高代码重构的效率和质量。通过不断优化和改进,语言模型将在软件开发中发挥越来越重要的作用。 。