探索TabFM如何通过零样本学习和合成数据训练,彻底改变表格数据分类与回归任务的处理方式,为企业级预测分析带来革命性变革。
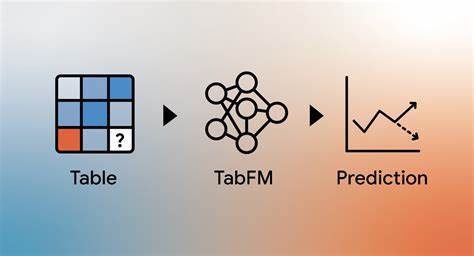
在人工智能领域,表格数据始终是企业级预测分析的核心。从客户流失预测到金融欺诈检测,这些结构化数据驱动着无数关键的机器学习应用。然而,传统的表格数据处理方法存在显著瓶颈:复杂的特征工程、耗时的超参数优化,以及对专业知识的高度依赖。随着Google Research团队推出TabFM - - 一款专为表格数据设计的零样本基础模型,这一局面正在发生根本性改变。TabFM通过将表格预测问题转化为上下文学习问题,彻底消除了传统机器学习流程中的繁琐步骤,为表格数据分析带来了前所未有的便捷性和高效性。 TabFM的核心创新在于其独特的混合架构设计。
传统机器学习模型依赖于针对特定数据分布的参数更新,而TabFM采用了完全不同的范式。它将整个数据集 - - 包括历史训练样本和目标测试行 - - 作为单一提示输入,在推理时直接从上下文中学习列与行之间的关系。这种方法避免了传统训练阶段的繁琐过程,使得模型能够在单次前向传播中生成高质量预测。 为了有效处理表格数据的二维结构特性,TabFM整合了TabPFN和TabICL的优势,形成了三个关键机制。首先,通过多层注意力模块对原始表格进行处理,交替对列(特征)和行(样本)进行注意力计算,从而捕捉复杂的特征交互和依赖关系。这种深度上下文化过程有效替代了传统的手工特征构建。
其次,将每个行的丰富交叉注意力信息压缩为单一密集向量表示。最后,专用的Transformer在压缩后的行向量序列上进行操作,通过在压缩向量而非原始网格上进行注意力计算,显著降低了计算成本,确保预测步骤保持高效。 训练基础模型的关键挑战在于获取高质量、多样化的训练数据。然而,真实世界的表格数据往往包含专有模式和敏感信息,难以用于广泛的预训练。TabFM采取了创新的解决方案:完全基于数百万个合成数据集进行训练。这些数据集通过结构因果模型动态生成,包含各种随机函数,从而捕捉到真实工业数据分析中常见的多样化分布和复杂特征关系。
这种合成数据训练策略使得TabFM能够在未见过的真实表格数据上表现出色,为其在实际应用中的泛化能力奠定了坚实基础。 为了验证TabFM的性能,研究团队在TabArena基准测试系统上进行了严格评估。TabArena是一个动态更新的基准系统,通过头对头胜率计算Elo评分。评估涵盖了38个分类数据集和13个回归数据集,样本量从700到150,000不等。测试结果显示,TabFM在两种配置下均表现出色:基础版本仅需单次前向传播即可生成预测,无需任何调优或交叉验证;而集成版本通过引入交叉特征和奇异值分解特征,进一步提升了性能。在分类任务中,集成版本还采用了Platt缩放作为额外的校准步骤。
TabFM的推出标志着表格数据分析领域的范式转变。通过将表格预测问题转化为上下文学习问题,TabFM成功消除了传统机器学习流程中的诸多瓶颈。其混合注意力架构和大规模合成数据训练策略,使得模型能够自动捕捉复杂特征交互,无需人工干预。这种零样本学习能力使得TabFM能够在单次前向传播中生成高质量预测,为企业级表格数据分析带来了前所未有的便捷性。 为了使TabFM的优势更广泛地惠及用户,Google正在将其集成到BigQuery中。在未来几周内,用户将能够通过简单的AI.PREDICT SQL命令在BigQuery中执行高级回归和分类任务,无需具备机器学习专业知识。
这种无缝集成将使得复杂的表格数据分析任务变得触手可及,为企业用户带来显著的效率提升。 TabFM的成功开发是团队协作的结果,涉及多位研究人员的共同努力。该项目由Erez Louidor Ilan、Taman Narayan、Shuxin Nie、Rajat Sen、Yichen Zhou、Joe Toth、Deqing Fu和Samet Oymak共同完成,Kimberly Schwede负责图形设计。这一创新成果展示了Google Research在推动机器学习技术进步方面的持续承诺,为表格数据分析领域带来了革命性的变革。 。