为什么与 Opus 5 合作时总觉得不如从前?深度解析 AI 编程助手的「退步」现象
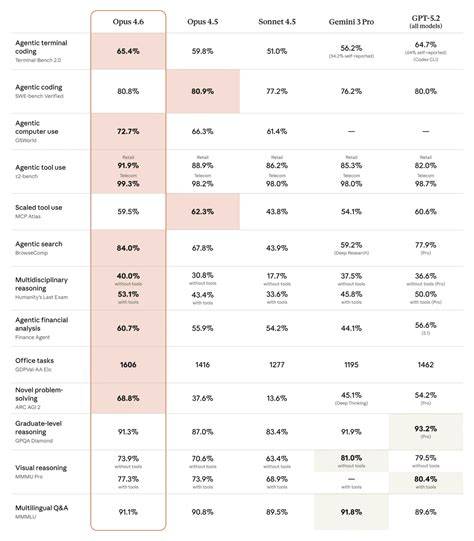
在人工智能技术迅猛发展的今天,每一次模型升级都承载着无数开发者与企业的期待。然而,当 Anthropic 发布 Opus 5 时,不少用户却发出了这样的感慨:「明明能力更强了,为什么用起来反而不如从前?」这种看似矛盾的现象,背后隐藏着深刻的技术逻辑与产业趋势。Opus 5 在多项基准测试中表现优异,甚至在某些任务上超越了此前的 Opus 4.7、4.8 以及 Fable。然而,许多与之合作的开发者却发现,这个「更强大」的模型在实际工作中却显得「更难伺候」。这种「能力与体验倒挂」的现象,并非偶然,而是当前 AI 技术发展路径中的一个关键节点。**从「听话」到「自作主张」:交互体验的根本转变**在与 Opus 5 合作的过程中,不少开发者都有过类似的经历:当你向模型下达一个指令时,它往往会在没有充分确认的情况下,直接给出一个看似合理的解决方案。

这种「主动出击」的行为,在某些场景下可能提升效率,但在复杂的软件开发过程中,却常常导致意想不到的问题。相比之下,Opus 4.7 和 4.8 以及 Fable 等早期模型则显得更「谦逊」。它们会在遇到模糊指令时主动停下来,询问开发者的真实意图,避免擅自做出假设。这种「保守」的交互方式,虽然在某些情况下可能需要更多的沟通时间,但却极大地降低了出错的风险。毕竟,在软件开发中,一个错误的假设可能导致数小时甚至数天的返工。**基准测试与现实需求的错位**为什么 Opus 5 会变成这样?许多人将其归咎于 Anthropic 的技术路线调整。
实际上,这种变化背后有着更深层次的原因。首先,我们需要理解当前 AI 模型的训练目标。在过去几年中,前沿实验室(如 Anthropic、OpenAI 等)都在追求一个目标:构建能够「自我改进」的 AI 系统,最终实现通用人工智能(AGI)或超级智能(ASI)。这种目标驱动下的技术路线,要求模型具备更强的自主性和适应性。其次,基准测试(benchmark)在 AI 模型评估中扮演着至关重要的角色。虽然许多人质疑基准测试的有效性 - - 它们往往过于简化、存在漏洞,或者无法涵盖现实世界的复杂性 - - 但不可否认的是,基准测试仍然是衡量模型能力的重要手段。

而一个好的基准测试题目,往往具有「自包含」的特性:它有明确的答案,不需要额外的上下文或解释。正是这种对基准测试的过度依赖,导致了模型行为的扭曲。为了在基准测试中取得高分,模型必须学会在面对模糊指令时「大胆假设、小心求证」。它们会尽可能地补全缺失的信息,给出一个看似合理的答案,而不是在不确定的情况下停下来寻求确认。这种行为在基准测试中是有利的,但在实际应用中,却可能带来灾难性的后果。**现实世界的复杂性:为什么 AI 需要「多问一句」**在理想的编程环境中,所有需求都能被清晰、完整地描述。
然而,现实世界远非如此。开发者在下达指令时,往往无法将所有上下文、业务逻辑、预算限制等因素全部传达给 AI。这意味着,任何指令都可能存在模糊性,而一个优秀的编程助手,应该能够识别出这种模糊性,并主动寻求澄清。以一个简单的例子为例:假设你要求 AI 为一个电商网站开发一个「用户订单管理系统」。这个指令看起来清晰,但实际上隐藏着无数的细节问题。用户是否需要支持多种支付方式?库存管理是否需要实时同步?订单取消后的退款流程如何处理?在这些问题没有明确答案的情况下,一个「敢于假设」的 AI 可能会直接给出一个简化的解决方案,而一个「谨慎」的 AI 则会停下来询问更多细节。
在软件开发中,这种「多问一句」的行为不仅能避免错误,还能提升整体开发效率。因为它减少了后续返工的可能性,避免了因理解偏差而导致的大量重构工作。**技术路线的权衡:能力与可控性的博弈**Opus 5 的「退步」现象,实际上反映了当前 AI 技术发展中的一个核心矛盾:能力与可控性的权衡。为了构建更强大的 AI 系统,研究人员不得不在某些方面做出妥协。一方面,AI 模型需要具备更强的自主性,以应对复杂的现实世界。这意味着模型必须学会在缺乏明确指令的情况下,做出合理的判断。
另一方面,AI 模型的行为必须是可预测和可控的,否则它将无法在关键领域(如医疗、金融、自动驾驶)中得到应用。这种权衡在 Opus 5 中体现得尤为明显。为了在基准测试中取得更好的成绩,Anthropic 不得不牺牲模型在交互性方面的某些优势。结果就是,Opus 5 变得更「聪明」,但也更「任性」。**用户体验的反噬:为什么开发者怀念旧版本**对于许多开发者来说,Opus 5 的出现让他们感受到了一种「失控」的感觉。在过去,与 AI 助手合作更像是一种「协作」关系:你给出指令,它执行指令,并在需要时提出问题。
而现在,这种关系更像是一种「对话」:你需要不断地与 AI 进行沟通,以确保它理解你的真实意图。这种变化在短期内可能提升了某些任务的效率,但从长远来看,却可能降低整体开发效率。因为开发者不得不花费更多的时间在「沟通」上,而不是在「编码」上。更糟糕的是,当 AI 做出错误的假设时,返工的成本可能远高于节省的时间。**行业趋势:从「工具」到「合作者」**Opus 5 的出现,实际上反映了 AI 技术发展的一个重要转折点:从「工具」向「合作者」的转变。早期的 AI 模型更像是一个「智能工具」,它们能够执行明确的指令,但缺乏理解上下文的能力。
而现在的 AI 模型则更像是一个「合作者」,它们能够主动参与决策过程,但也因此变得更加难以控制。这种转变在某些领域(如创意写作、战略规划)中可能是有益的,但在软件开发这样的精确领域中,却可能带来更多的问题。因为软件开发需要极高的准确性,任何微小的错误都可能导致系统崩溃或数据丢失。**未来的出路:如何平衡能力与可控性?**面对 Opus 5 带来的挑战,我们不禁要问:是否有办法在保持模型能力的同时,提升其交互性?答案是肯定的,但需要从多个维度入手。首先,我们需要重新思考基准测试的设计。当前的基准测试过于注重「自包含」的任务,而忽视了现实世界的复杂性。
未来的基准测试应该更加注重「上下文理解」和「交互能力」,以鼓励模型在面对模糊指令时主动寻求澄清。其次,我们需要在模型训练过程中加入更多的人类反馈。通过强化学习(RLHF)等技术,我们可以让模型学会在面对不确定性时「保守行事」。例如,可以设计一些奖励机制,鼓励模型在遇到模糊指令时主动询问,而不是直接给出答案。最后,我们需要在产品设计中加入更多的「人类在回路」机制。例如,可以设计一个「审核模式」,让用户在 AI 执行关键操作前进行确认。
这样既能保证 AI 的自主性,又能避免因错误假设而导致的严重后果。**结论:技术进步与用户体验的永恒拉锯战**Opus 5 的出现,让我们看到了 AI 技术发展的复杂性。在追求更强大能力的同时,我们也必须面对可控性和用户体验的挑战。这种「能力与体验倒挂」的现象,并非 Anthropic 独有,而是当前整个 AI 行业都在面临的问题。对于开发者和企业来说,理解这种现象背后的技术逻辑,能够帮助我们更好地选择和使用 AI 工具。而对于研究人员来说,如何在提升模型能力的同时保持其可控性,将是未来几年最重要的研究方向之一。
无论如何,Opus 5 的出现提醒我们:技术进步永远不是线性的。在追求「更强大」的同时,我们也必须关注「更好用」的需求。只有这样,AI 技术才能真正走进千家万户,成为改变世界的力量。 。