Xcena与三星MX1:突破性的近内存计算CXL设备深度解析
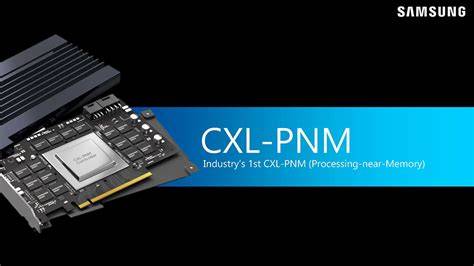
随着大模型和深度学习对显存容量的需求急剧增长,传统的PCIe通道和本地内存已难以满足日益膨胀的数据吞吐量。近内存计算(Near‑Memory Compute)通过在内存扩展设备内部嵌入计算资源,让数据在靠近存储的位置完成处理,从而显著降低跨链路的数据搬运开销。Xcena与三星联合研发的MX1(Memory Xcelerator)正是这一理念的典型实现,它不只是一块普通的CXL内存扩展卡,更是一套集内存、存储与加速于一体的完整系统。 MX1的核心规格展现了它在容量与带宽上的双重优势。该卡最多可容纳2 TB的DDR5内存,并通过PCIe 6/CXL 3.2 x8接口与主机相连,提供128 GB/s的峰值带宽(单向64 GB/s)。在主机侧的带宽受限的情况下,MX1还预留了八条下游PCIe 6通道用于直接连接NVMe SSD,SSD可以以"内存"形态暴露给操作系统,而卡上自带的DRAM则充当高速缓存,实现Infinite Memory的概念。

由于下游PCIe与上游CXL链路的带宽相匹配,理论上仅凭SSD即可饱和对主机的传输速率,大幅提升大规模数据加载的效率。 在计算层面,MX1采用了极为密集的RISC‑V核心阵列。整颗芯片容纳了3072个RISC‑V内核,按32核为一组的集群划分,每四个集群再组成一个子系统,子系统被视为最小的作业分配单元,共计24个子系统,可同时运行24个独立任务。核心主频仅为1.1 GHz,采用顺序执行设计,单核功耗约13 mW,整体芯片功耗在40 W左右(加上四根DDR5 DIMM的全卡功耗约90 W)。这种"低频大量"的策略与早期Intel Xeon Phi的思路相呼应,专注于数据并行的工作负载,让每个核尽可能利用高带宽的内部互联,而不是追求单核的极限时钟频率。 缓存层次结构的设计进一步凸显了MX1在访问效率上的细腻考量。
每个RISC‑V核心拥有4 KB的虚拟寻址L1数据缓存,只有在L1缺失时才会进行地址翻译;128 KB的L2数据缓存在每个集群内共享,并采用虚拟索引物理标记(VIPT),使得索引过程可以与TLB查询并行进行。四颗核心共享一个8 KB的指令缓存,旨在容纳热点循环的内核代码;而在更上层,128 KB的L2指令缓存覆盖更大的指令足迹。值得注意的是,指令取址直接使用物理地址,从而规避了页表遍历和TLB查找,进一步降低指令获取的延迟。 在内存管理方面,MX1与主机共享同一套虚拟地址空间,程序可以在主机和加速卡之间直接传递指针,类似OpenCL的SVM(Shared Virtual Memory)模型。为了保持映射一致性,MX1在每个子系统内部维护了1024项的TLB,支持64 KB大页和1 GB超页,以在扩展内存场景下减少TLB Miss的代价。64 KB页的大小还与SSD块大小天然对齐,便于在缓存失效时进行块级的读写合并。

MX1的编程模型借鉴了GPU加速框架的设计思路:开发者只需编写一次kernel,然后通过类似mu::getTaskIdx()的函数获取全局工作项索引,框架会自动将该索引映射到对应的RISC‑V核心上执行。由于指令缓存是四核共享的,小型循环极有可能在同一时刻被多个核心取指,指令缓存可以通过广播读取一次性满足多个请求,提高指令命中率。这种"一次编写、多次并行"的模式极大降低了在RISC‑V集群上移植并行算法的门槛。 在向量计算方面,Xcena在RISC‑V的可扩展指令集上加入了自定义的向量处理引擎(VPE)。VPE在子系统层面作为一个共享协处理器存在,每个RISC‑V核心都配有命令队列,可通过专用指令将向量运算请求提交给VPE。该引擎支持FP32和FP16两种精度的点积运算,整体提供约3 TFLOPS的峰值算力。
以1.1 GHz的工作频率计算,每个VPE每周期可完成约128次浮点运算,足以应对大多数矩阵乘法和卷积操作的加速需求。值得注意的是,VPE目前仅针对浮点运算进行优化,整数运算仍由RISC‑V核心本身负责,这在一定程度上体现了设计者对"计算密集、内存带宽敏感"工作负载的定位。 MX1的SSD即内存功能(Infinite Memory)是其最具创新性的特性之一。主机操作系统将挂载在MX1下游PCIe通道上的NVMe SSD视为一块普通的CXL内存条,数据首先被映射到卡上DRAM形成缓存;当缓存未命中时,固件会在RISC‑V核心上触发页错误处理例程,从SSD读取相应块并更新映射表。为了加速映射查找,MX1内置了1024项的映射缓存(相当于TLB),可以在毫秒级别完成大块数据的换入。映射缓存的容量与DRAM缓存总量之间的对应关系由固件动态调配,默认提供16 GB的缓存空间,并可按16 MB的步进进行微调。
为了进一步优化访问延迟,MX1支持"固定前缀"(pinned prefix)机制,即把SSD对应地址区间固定映射到DRAM的特定连续区域。该前缀大小同样可按16 MB步进配置,用户可以将热点缓冲区锁定在高速DRAM中,避免频繁的页面换入换出。固定前缀的优势在于能够保证对关键数据块的访问始终在亚微秒级完成,但缺点是只能覆盖连续的地址空间,缺乏细粒度的页级调度灵活性。因此,固定前缀最适合作为模型权重、特征矩阵或大型索引等一次性加载后持续访问的存储区域。 在与主机内存子系统的协同方面,MX1利用CXL.mem的snoop(嗅探)机制实现缓存一致性。设备可以在需要时向主机的CPU缓存发送回写或失效信号,使得加速核写入的数据能够立即对主机可见,而无需将对应的内存区域标记为不可缓存。
这一特性相较于传统的PCIe内存映射I/O(MMIO)方式,避免了因缓存不可缓存导致的性能下降,也省去了程序员手动刷缓存的繁琐步骤。Xcena在官方文档中指出,MX1能够在同一块内存上支持CPU和GPU的并发访问,这为异构计算提供了更大的设计空间。 从性能对比来看,MX1的3 TFLOPS算力虽然不及现代高端独立显卡(例如Nvidia GeForce RTX系列的上百TFLOPS),但它的真正价值在于"算力靠近带宽"。在传统的加速卡设计中,计算单元必须通过CXL或PCIe链路将数据从主机内存搬入加速卡,受限于链路带宽(通常在数十GB/s量级),即使拥有数十TFLOPS算力,实际有效算力也会被带宽瓶颈所压制。MX1通过在卡内部实现完整的计算和缓存子系统,使得大部分数据访问可以本地完成,显著降低跨链路的数据搬运量。即便在极端情况下只能依赖SSD提供的带宽,MX1的理论有效算力仍可超过200 GFLOPS,远高于同等带宽条件下的传统加速方案。
在实际应用场景中,MX1的定位更适合作为大规模内存扩展与近数据加速的融合平台。例如,在训练阶段,大型语言模型的参数和中间激活值往往需要占用数十GB甚至上百GB的显存,传统GPU显存往往不够,需要跨节点访问分布式内存;MX1通过Infinite Memory将TB级别的SSD空间虚拟为高速内存,同时在卡上运行RISC‑V核心完成参数预取、梯度聚合等内存密集型任务,从而在不增加网络开销的情况下扩展可用内存容量。在推理阶段,MX1可以将模型权重固定在DRAM缓存中,利用VPE进行高效的矩阵乘法加速,同时通过CXL链路将结果返回给主机CPU,实现低延迟的推理服务。 从生态系统角度看,Xcena为MX1提供了完整的软件栈,包括基于LLVM的RISC‑V交叉编译工具链、类OpenCL的kernel编程接口以及针对VPE的高级函数库。开发者可以在熟悉的CUDA/OpenCL风格下编写并行代码,然后交由MX1的调度器自动将工作分配到底层的RISC‑V集群和VPE上。固件层面则提供了页错误处理、缓存一致性维护以及功耗管理等功能,确保在不同工作负载下系统能够保持稳定的性能与能耗表现。
展望未来,随着CXL 4.0规范的逐步落地和PCIe 6.0的普及,近内存计算有望从数据中心向更广泛的消费级市场渗透。Xcena在MX1上实现的"内存+存储+计算"三位一体架构,展示了将现有闲置DRAM和SSD资源整合为高效加速平台的可行性。如果未来能够将类似的设计进一步小型化、成本降低,普通用户也可以通过插入MX1级别的扩展卡来为自己的工作站或游戏主机提供额外的算力与内存资源,实现"一卡多用"。 总体而言,MX1代表了近内存计算在商业化道路上的重要里程碑。它通过高密度的RISC‑V核心集群、可扩展的向量加速引擎以及创新的Infinite Memory技术,巧妙地解决了大容量内存扩展与高带宽计算之间的矛盾。随着AI模型规模的持续增长和数据密集型应用的广泛普及,MX1所提供的"靠近数据的计算"模式,有望在未来的高性能计算、云服务以及边缘推理等领域发挥关键作用。
。