深入探讨AI医疗记录系统普遍存在的"遗漏盲区"问题,揭示传统审查方法在检测信息缺失方面的根本缺陷,并解析最新的解决方案与临床验证效果。
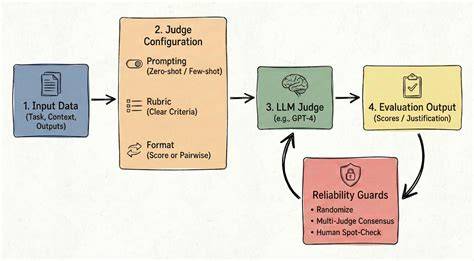
人工智能正在悄然改变医疗记录的撰写方式。从问诊对话到结构化病历,AI辅助生成工具承诺为医生节省宝贵的时间,让临床工作者从繁琐的文字工作中解放出来。然而,一项最新研究揭示了一个令人担忧的事实:当前广泛部署的AI医疗记录系统,其最严重的错误并非凭空捏造,而是遗漏 - - 那些本该被记录却消失于无形的关键信息。 研究发现的核心问题在于审查机制本身。当我们使用一个大语言模型来评判另一个大语言模型生成的医疗笔记时,这些"审查员"擅长发现笔记中凭空出现或被篡改的内容,却对真正缺失的信息视而不见。这种现象被研究者称为"遗漏盲区",它意味着当前依赖AI审查AI的医疗质控体系存在系统性漏洞。

更值得关注的是,研究团队通过精心设计的基准测试发现,即便是经过专门优化、采用多数投票机制或调整提示词的八种不同审查方案,在检测单一遗漏时其表现几乎等同于随机猜测。具体数据显示,在识别"添加或篡改内容"时,审查方案的配对辨别能力维持在零点七九至零点九四的较高水平;但面对"信息遗漏"这一核心问题时,其表现骤降至零点五至零点六三的区间,仅相当于抛硬币的概率。这一鲜明对比暴露了现有技术路线的根本局限:传统审查范式本质上是在验证信息的"存在",而非验证信息的"完整性"。 面对这一困境,研究者并未止步于揭示问题,而是提出了两条突破性的解决路径。第一条路径是构建一个分步处理管道:首先让模型系统性地列出对话中确立的所有关键事实,然后再逐一比对笔记是否完整覆盖。这种方法的优势在于其输出的错误标记能够明确指出遗漏的具体事实及其严重程度,仅产生百分之二点七的误报率。
第二条路径则通过进化式提示优化,将同样的逻辑封装在单次调用中完成。尽管这种集成方法检测出更多遗漏(在百分之三点六九的更高水平上发现遗漏,而分步管道为百分之二十四点六),但代价是误报率上升至百分之六点二。有趣的是,当两种方案发生分歧时,作为论文作者之一的临床医师在十个案例中全部认同分步管道的判断,这一统计学显著性达到百分之零点二的结果提示我们:更高的检出率并不等同于更高的准确性。 在真实临床场景的验证中,研究团队收集了部署中的AI医疗记录系统的实际输出,对比实验室基准测试的结果后得出了一个重要警示:在受控环境中表现出色的阈值参数,无法直接迁移到真实应用环境。但在同一数据集上重新校准后,单次调用方案的检测能力超越了所有八种传统审查方案,同时将误报率降低了一半。这一发现既证明了新方法的实用价值,也提醒我们任何医疗AI的质量评估都不能脱离实际部署环境。

两种方案共同存在一个无法回避的局限:当遗漏的信息以另一种形式在笔记的其他位置被重述时,两种方法都会失效。这意味着AI医疗记录系统可能通过"语义重组"来规避审查 - - 将关键事实拆解、变换措辞、分散记录,从而让系统误以为信息已被保留。这种"信息伪装"现象提示我们,未来的医疗AI质控需要从单一文档的局部比对,转向对整份病历语义完整性的全局理解。 这项研究的意义远超技术层面。当全球医疗系统加速引入AI辅助工具时,我们不能将临床安全寄托于"AI审查AI"的循环验证。研究揭示的"遗漏盲区"现象,实质上反映了一个更根本的认知偏差:人类和AI都更容易注意到"存在的事物",而对"应该存在却不存在的事物"缺乏敏感性。
这一认知规律在医疗领域可能造成的后果是,医生在查阅AI生成的病历时,会基于"所见即所诊"的假设做出临床决策,而忽视了对话中已确立但未被记录的关键信息。 从技术演进的角度看,这项研究开辟了一个新的研究方向。我们需要重新思考医疗AI的评估范式,从关注"生成内容的准确性"转向关注"临床信息的完整性"。具体而言,未来的医疗AI系统应当内建"完整性自检"机制,在生成病历的最后一刻,系统性地比对原始对话与最终输出,确保每一个临床决策所依赖的信息都得到了忠实记录。这种"完整性优先"的设计哲学,将与传统的"准确性优先"形成互补,共同构建更可靠的临床AI系统。 对于医疗机构的IT决策者而言,这项研究提供了三个立即可操作的启示。
首先,在选择AI医疗记录供应商时,应当将"信息完整性"作为独立于"文本流畅度"的核心评估指标,要求供应商提供关于遗漏率的详细数据,而非仅仅展示生成样本的表面质量。其次,应当建立独立于AI系统的"完整性审查"机制,这一机制可以基于规则引擎,也可以采用经过验证的新一代审查方案,但绝不能依赖AI生成系统的自我声明。第三,应当建立临床医师的反馈闭环,让使用AI病历的医生能够便捷地标记遗漏情况,这些真实的临床反馈将成为持续改进AI系统的宝贵资源。 从监管视角看,这项研究为医疗AI的标准化评估提供了重要参考。当前各国在审批医疗AI产品时,主要关注的是诊断准确性、治疗建议合理性等正向指标,而对"信息完整性"这一负向指标缺乏明确的评估框架。研究者建议,监管机构应当要求医疗AI供应商提供关于信息遗漏率的标准化报告,这一指标应当与诊断准确率具有同等重要的地位。
只有将"不遗漏"提升到与"不错误"同等重要的位置,才能真正实现医疗AI的安全部署。 值得注意的是,研究中提出的"分步处理"与"单次调用"两种方案并非互相排斥,而是针对不同临床场景的互补选择。在高风险科室(如急诊、重症监护)以及对病历完整性要求极高的场景(如手术记录、知情同意),分步管道的低误报率特性使其成为更可靠的选择;而在门诊量大、对效率要求更高的普通门诊场景,单次调用方案的高检出率则能更好地发挥"安全网"的作用。这种"因科而异"的部署策略,体现了医疗AI落地需要精细化设计的重要原则。 研究团队在论文中还发布了一个重要的基准数据集和开源代码,这为整个医疗AI社区提供了共同的研究基础。在过去,医疗AI的评估往往面临"缺乏金标准"的困境,因为真实的临床对话与官方病历之间往往存在显著差异,而研究团队通过精心构建的测试集,巧妙地绕过了这一难题:他们从已审计的事实清单中创建配对样本,确保每个测试样本都只有一个明确的错误,这为后续的算法迭代提供了清晰的优化目标。
展望未来,这项研究开启的不仅是一个技术问题的解决方案,更是一种研究范式的转变。它告诉我们,在AI系统日益渗透医疗领域的今天,我们不能仅仅满足于"让AI做对的事",更要关注"让AI不遗漏该做的事"。前者关乎正确性,后者关乎完整性;前者可以通过对抗性测试来评估,后者则需要建立全新的评估框架和基准数据集。只有当这两个维度都得到充分关注时,AI才能真正成为医生的可靠助手,而非潜在的临床风险源头。 在人工智能与医疗深度融合的时代,这项研究为我们敲响了警钟:技术的进步不仅意味着"能够做什么"的拓展,更意味着"必须做好什么"的责任。从遗漏盲区的揭示到解决路径的探索,从实验室验证到临床部署的考量,这一研究完整地呈现了一个负责任的医疗AI研究应当具备的全链条思维。
对于所有关注医疗AI未来的从业者、研究者和政策制定者而言,这都是一份值得反复研读的重要文献。 。