在Docker和Kubernetes上使用Litestream运行SQLite应用完整指南
了解如何在Docker和Podman单节点环境以及Kubernetes集群中利用Litestream实现SQLite数据库的持续复制和自动恢复,打造高可用的SQLite生产环境
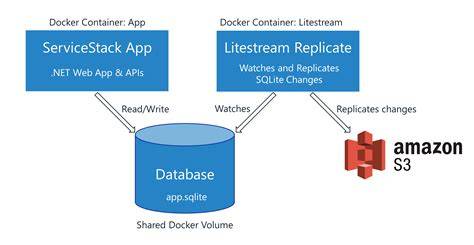
在现代应用开发中,数据库的选择和部署方式一直是开发者关注的核心问题。传统观念认为,像SQLite这样的嵌入式数据库只适合单机或小型应用场景,难以在生产环境中承担关键业务的数据存储任务。然而,随着Litestream这一革命性工具的出现,SQLite的生产级部署变得前所未有的简单和可靠。本文将深入探讨如何在Docker和Kubernetes环境中充分利用Litestream来实现SQLite应用的持续复制、自动备份和灾难恢复,帮助开发者在保持SQLite简洁易用特性的同时,获得企业级的数据安全保障。Litestream是一个专为SQLite设计的流式复制工具,它能够将数据库的所有变更实时同步到S3兼容的对象存储中,实现近乎实时的数据备份和点时间恢复能力。与传统数据库需要运行独立的服务器进程不同,SQLite是嵌入式数据库,数据直接存储在文件中,而Litestream正是监视这个文件的变化,并将变更增量地传输到远程存储。

这种设计使得SQLite应用可以像使用传统数据库一样获得持久化的数据保护,同时又保留了嵌入式数据库的轻量级优势。在容器化部署场景中,这种特性尤为重要,因为容器默认是非持久化的,任何容器内的数据在容器销毁后都会丢失,Litestream提供的复制机制完美解决了这一难题。对于在Docker和Podman上运行应用的场景,OpenRun平台提供了开箱即用的Litestream集成支持。开发者无需在自己的应用镜像中安装任何Litestream相关的组件,平台会自动为每个需要SQLite持久化的应用启动一个伴随容器来执行复制任务。这个伴随容器与主应用容器共享同一个数据卷,确保能够实时捕获数据库文件的所有变化。在应用启动时,如果检测到数据卷为空或者数据卷是新创建的,平台会先运行恢复容器从对象存储中拉取最新的数据库副本,然后再启动应用容器。
这种设计确保了即使在容器被删除后重新创建的情况下,应用也能获得最近的数据状态,实现真正的有状态容器部署。OpenRun平台的配置过程也极为简洁。开发者只需要在服务器配置文件中定义一次Litestream的连接信息,包括S3存储桶名称、区域设置以及访问凭证,然后创建一个SQLite服务并将其标记为默认服务,最后在创建应用时指定绑定到该服务即可。整个配置过程不需要修改任何应用代码,也不需要重新构建应用镜像,真正实现了平台能力与应用代码的解耦。对于习惯使用声明式配置管理的团队,这种方式尤其友好,因为所有的配置都可以存储在Git仓库中,通过GitOps的方式进行版本管理和部署。Kubernetes环境下的部署虽然技术细节有所不同,但核心概念是相通的。

当OpenRun将应用部署到Kubernetes集群时,应用绑定的卷会变成一个PersistentVolumeClaim,Kubernetes会负责管理这个持久化卷的生命周期。在Pod的启动过程中,OpenRun会自动注入一个恢复初始化容器和一个Litestream边车容器。对于Kubernetes 1.29及更新版本,原生的边车容器功能使得Litestream能够在应用容器启动之前就开始运行,并在应用容器终止后继续运行一段时间以确保完成最后的同步操作。这种生命周期管理确保了数据的一致性,即使在Pod被优雅终止或意外终止的情况下,也能最大程度地减少数据丢失的风险。Kubernetes中运行SQLite应用还需要注意复制策略的问题。由于SQLite本身的设计特性,同一时间只能有一个写入进程,因此OpenRun会自动将为SQLite绑定创建的应用设置为单副本运行,并使用Recreate更新策略而非默认的RollingUpdate策略。
Recreate策略意味着在进行更新时,Kubernetes会先删除旧的Pod,等待其完全终止并完成数据同步后,才会创建新的Pod。这种方式避免了多个应用实例同时写入同一个卷而导致的数据库锁定和数据损坏问题。虽然这种部署模式牺牲了一定的可用性,但它确保了数据的完整性和一致性,对于大多数内部工具和中小型Web应用来说是完全可以接受的权衡。在数据恢复方面,Litestream提供了多种场景下的自动恢复能力。当应用的持久化卷意外丢失或被删除时,下次应用启动时OpenRun会检测到数据卷为空,自动触发恢复流程。恢复容器会连接到对象存储,根据应用绑定信息找到对应的数据副本,并将数据库文件拉回到新创建的数据卷中。
整个过程对应用完全透明,应用只需要按照正常方式启动即可。恢复后的数据会尽可能接近最后一次成功同步的状态,对于默认的一秒同步间隔配置,最多只会丢失约一秒钟的写入数据。这种恢复机制不仅适用于应用数据,还适用于OpenRun平台自身的元数据和审计数据库。只要在服务器配置中启用了元数据复制选项,平台会在启动时自动检查自身数据库的状态,必要时从对象存储恢复元数据和审计历史,确保所有应用配置、绑定信息、版本记录和审计日志都完整保留。对于更严重的灾难恢复场景,比如整个运行OpenRun的节点完全丢失的情况,恢复过程同样简洁明了。管理员只需要在新的机器上安装OpenRun,使用相同的配置文件启动服务器即可。
服务器启动时会检测到元数据库缺失,自动从对象存储恢复所有平台数据,然后依次恢复每个应用的数据库。整个恢复过程不需要人工干预,配置信息完全存储在版本控制的配置文件中,管理员只需要确保新的机器能够访问到之前配置中引用的密钥即可。这种设计大大简化了灾难恢复的操作复杂度,即使是非专业的运维人员也能顺利完成整个恢复流程。关于复制状态的监控,OpenRun提供了专门的命令来查看所有复制任务的实时状态。通过执行复制状态命令,管理员可以查看每种数据类型的复制目标、使用的配置、同步状态、上次同步时间、复制的文件数量以及关联的应用信息。状态字段会显示健康、待处理或异常等不同状态,这些信息综合了对象存储中的副本列表和复制容器的运行状态,因此即使对象存储服务正常工作,只要复制容器出现故障也能被及时发现。
对于需要图形化界面的用户,OpenRun还提供了Console应用来可视化查看复制状态,包括实时的同步进度和历史趋势。在实际生产环境中使用Litestream和SQLite组合时,还需要遵循一些最佳实践来确保应用的最佳性能和可靠性。首先是WAL模式的正确使用,SQLite的Write-Ahead Logging模式能够显著提升并发读写性能,建议在应用初始化时执行相应的PRAGMA命令来启用WAL模式。其次是合理设置忙等待超时时间,由于在容器化环境中可能会有多个进程尝试同时访问数据库,设置适当的busy_timeout值能够避免不必要的访问失败。此外,保持写入事务的简短也很重要,Litestream会在事务提交时捕获数据变更,因此过长的事务会延迟复制的时机并增加潜在的数据丢失窗口。对象的存储选择方面,Litestream支持多种S3兼容的后端,包括AWS S3、Cloudflare R2、MinIO和SeaweedFS等。
AWS S3是最常见的选择,具有高可用性和持久性保证,而Cloudflare R2则提供了无需出口流量费用的优势,特别适合数据量较大的场景。对于需要在私有化环境中运行的用户,MinIO提供了完全自托管的解决方案,而SeaweedFS则以其高效的存储利用率著称。选择哪种存储后端应该基于数据量、访问模式、成本考量和合规要求等因素综合决定。在性能方面,Litestream的默认同步间隔是一秒,这意味着在正常情况下最多会丢失最近一秒内的数据变更。对于绝大多数内部工具和小型Web应用来说,这个级别的数据保护已经完全足够。如果需要更强的保护,可以将同步间隔缩短到更短的时间,但这会增加对象存储的请求次数和成本。
另一方面,如果应用可以容忍更长的恢复点目标,也可以将间隔适当延长以降低成本。总的来说,Litestream为SQLite应用提供了一套完整的数据保护解决方案,使得在容器化和云原生环境中运行有状态的SQLite应用成为可能。它巧妙地平衡了简单性、功能性和可靠性,让开发者能够专注于应用本身而不是数据备份和恢复的复杂逻辑。通过OpenRun这样的平台集成,用户甚至不需要了解Litestream的技术细节,就能享受到持续复制带来的数据安全保障。随着云原生技术的不断发展和企业对数据主权、成本控制的需求日益增长,这种轻量级但功能强大的数据库部署模式必将在未来获得更广泛的应用。无论是初创公司快速迭代开发,还是大型企业的内部工具建设,选择在Docker和Kubernetes上使用Litestream运行SQLite应用都是一个值得考虑的现代化解决方案。
它既继承了传统SQLite的简洁和高效,又通过与容器化技术的深度结合获得了现代云原生应用所需的可移植性和持久性,真正实现了鱼与熊掌的兼得。 。