SpaceXAI Grok 4.6震撼登场:以61分智能指数跻身前沿,成本效益比超越Claude与GPT-5
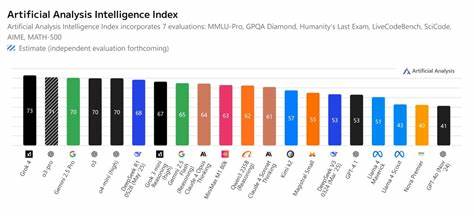
在人工智能技术日新月异的今天,大模型的竞争已然进入白热化阶段。近日,SpaceXAI(SpaceX旗下的人工智能公司)发布的Grok 4.6在Artificial Analysis(人工智能分析平台)的智能指数评测中,以61分的成绩强势登顶,与OpenAI的GPT-5.6 Sol并列前沿阵营,仅次于Anthropic的Claude Opus 5。这一成绩不仅标志着Grok系列在智能水平上的重大突破,更在代理能力(agentic performance)和成本效益比方面展现出了令人瞩目的优势。Grok 4.6的横空出世,意味着SpaceXAI在大模型领域的又一次里程碑式进展。从Grok 4.3到Grok 4.5,再到如今的Grok 4.6,SpaceXAI仅用一个多月的时间就实现了5分的智能指数提升,相比Grok 4.3更是实现了23分的飞跃。这一速度不仅体现了SpaceXAI在技术研发上的高效投入,更证明了其在大模型优化方面的深厚积累。

**智能指数61分:与顶级模型并驾齐驱**在Artificial Analysis的智能指数评测中,Grok 4.6以61分的成绩与GPT-5.6 Sol(满分)并列前沿阵营,仅次于Claude Opus 5(满分63分)和Claude Fable 5(满分62分),领先于Kimi K3等其他竞争对手。这一成绩的取得,离不开SpaceXAI在模型架构、训练数据和优化算法上的持续创新。与传统的静态推理测试不同,Artificial Analysis的智能指数更加注重模型在实际应用场景中的表现。Grok 4.6在代理能力评测中表现出色,在GDPval-AA v2(代理能力评测基准)中斩获1753分的Elo评分,仅次于Claude Opus 5,与Claude Fable 5和Qwen3.8 Max的评分区间重叠。这意味着Grok 4.6在处理复杂代理任务时,能够与顶级模型一较高下。**代理能力表现:在多个维度上超越竞争对手**Grok 4.6在代理能力方面的表现尤为突出,这也是其能够在智能指数评测中脱颖而出的关键所在。
在𝜏³-Banking(多轮客户服务任务)评测中,Grok 4.6以50.7%的成绩位列前两名,与Qwen3.8 Max(51.3%)不相上下。而在Terminal-Bench v2.1(终端软件任务)评测中,Grok 4.6以88.4%的成绩与领先模型持平。这种在多个维度上的均衡表现,使得Grok 4.6在代理任务中具有极高的实用性。更为难能可贵的是,Grok 4.6在长时序代理知识工作(AA-Briefcase评测)中的表现同样出色。在Artificial Analysis的私有评测基准中,Grok 4.6以1577分的Elo评分位列Claude Fable 5级别,领先于其他大多数竞争对手。这表明Grok 4.6在处理长时序、复杂任务时,能够保持稳定的性能表现。

**成本效益比:以更低价格实现更高智能**在大模型竞争日趋激烈的今天,成本效益比已成为评判模型优劣的重要指标之一。Grok 4.6在这一点上表现出色,其实际表现与价格优势使其在成本效益比评测中位列前茅。Grok 4.6的定价保持与Grok 4.5一致,即每百万输入/输出token分别为2美元和6美元,相比Claude Opus 5(5美元/25美元)和GPT-5.6 Sol(5美元/30美元)的定价,Grok 4.6的成本优势极为明显。在实际任务成本方面,Grok 4.6的每任务成本仅为0.84美元,与Kimi K3相当,但智能水平略高,使其在成本效益比评测中位列帕累托前沿(Pareto frontier)。值得一提的是,Grok 4.6在长时序代理知识工作中的效率表现同样令人印象深刻。在AA-Briefcase评测中,Grok 4.6平均完成任务所需的轮次仅为53轮,输入token数约为0.5B,而Claude Opus 5(满分)则需要103轮和2.0B输入token。
这意味着Grok 4.6在处理长时序任务时,能够以更少的计算资源和时间成本实现相近的结果,进一步提升了其成本效益比。**技术规格与创新亮点**除了在智能指数和代理能力方面的优异表现,Grok 4.6在技术规格上也展现出了诸多创新亮点。首先,Grok 4.6的上下文窗口(context window)扩展至50万token,与Grok 4.5保持一致,这使得模型能够处理更长的文本输入,满足更复杂的应用场景需求。在定价策略上,Grok 4.6继续沿用Grok 4.5的定价模式,即每百万token输入/输出分别为2美元和6美元。此外,Grok 4.6还引入了缓存命中(cache hits)的折扣优惠,缓存命中token的价格从Grok 4.5的0.3美元/百万token提升至0.5美元/百万token,进一步降低了用户的使用成本。**与竞争对手的对比分析**在当前的大模型市场中,Grok 4.6面临的竞争对手包括Anthropic的Claude Opus 5、OpenAI的GPT-5.6 Sol、Qwen3.8 Max以及Kimi K3等。
通过与这些顶级模型的对比分析,我们可以更清晰地看到Grok 4.6的优势与不足。在智能指数方面,Grok 4.6以61分与GPT-5.6 Sol并列前沿,仅次于Claude Opus 5(63分)和Claude Fable 5(62分)。在代理能力评测中,Grok 4.6的Elo评分为1753,仅次于Claude Opus 5,与Claude Fable 5和Qwen3.8 Max不相上下。在长时序代理知识工作评测中,Grok 4.6以1577分位列Claude Fable 5级别,领先于其他大多数竞争对手。在成本效益比方面,Grok 4.6的定价优势极为明显。相比Claude Opus 5和GPT-5.6 Sol,Grok 4.6的定价仅为其三分之一左右,而智能水平却与之相当。
这使得Grok 4.6在成本效益比评测中位列帕累托前沿,成为用户在选择大模型时的重要考虑因素。**应用场景与未来展望**Grok 4.6的强势表现,使其在多个应用场景中具有广阔的应用前景。首先,在企业级应用中,Grok 4.6的代理能力和长时序处理能力使其成为企业自动化、客户服务、数据分析等场景的理想选择。其次,在开发者工具领域,Grok 4.6的高效代理能力和成本优势,使其成为开发者构建智能应用的强大助手。展望未来,SpaceXAI有望在Grok 4.6的基础上进一步优化模型性能,推出更多创新功能。随着大模型技术的不断发展,Grok系列有望在人工智能领域继续扮演重要角色,为用户带来更多智能化解决方案。
**总结**SpaceXAI的Grok 4.6以61分的智能指数强势登顶,与GPT-5.6 Sol并驾齐驱,在代理能力和成本效益比方面展现出了令人瞩目的优势。这一成绩的取得,离不开SpaceXAI在技术研发和模型优化方面的持续投入。随着Grok 4.6的推出,SpaceXAI在大模型领域的竞争力进一步提升,为用户带来了更多智能化解决方案的选择。在未来的发展中,我们有理由期待Grok系列能够继续推陈出新,为人工智能领域的发展贡献更多力量。无论是企业级应用还是开发者工具,Grok 4.6都将成为用户不可或缺的重要工具之一。 。