从Julia到Rust:科学计算时代的可微分张量栈
探讨科学计算领域从Julia到Rust的转型,分析tenferro-rs项目如何构建高效、可扩展的张量计算框架,并探讨AI时代编程语言的选择与未来趋势
科学计算领域正经历着一场深刻的变革。随着人工智能技术的快速发展,传统的编程范式正在被重新审视。近日,来自日本埼玉大学的Hiroshi Shinaoka及其团队推出了一个名为tenferro-rs的Rust原生张量计算框架,这一项目不仅代表了科学计算工具的技术进步,更反映了编程语言选择的深刻变化。从Julia到Rust的转型,背后蕴含着哪些深层次的原因?tenferro-rs又如何在科学计算领域发挥其独特的作用?本文将从多个维度深入探讨这些问题。在科学计算领域,张量网络代码的开发通常以Julia语言为主。Julia以其接近数学表达的语法和高效的执行性能,成为许多研究人员的首选。

然而,随着项目规模的扩大,Julia的开发效率开始显现出一些局限性。类型不稳定、编译时间过长以及代码正确性难以验证等问题,使得大型项目的开发变得越来越困难。当团队需要将张量网络栈整合到更大的系统中时,这些问题变得无法忽视。因此,团队决定将计算引擎迁移到Rust语言。Rust语言以其强大的类型系统和内存安全特性,成为科学计算领域的新宠。Rust的所有权机制和生命周期管理,能够在编译期消除大量运行时错误,这对于确保代码的正确性至关重要。
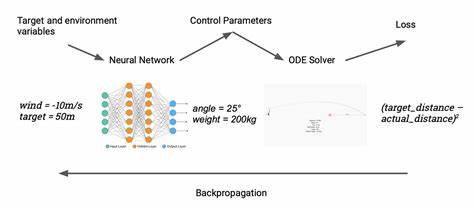
此外,Rust的构建工具cargo能够高效地处理依赖管理、测试和基准测试,显著提升了开发效率。在AI代码生成的时代,Rust的这些特性使其成为更为可靠的选择。tenferro-rs项目的核心目标是构建一个高效、可扩展的张量计算框架。该框架不仅支持PyTorch风格的即时自动微分和JAX风格的跟踪变换,还提供了NumPy风格的einsum操作、快速傅里叶变换以及显式的CPU/CUDA后端支持。项目团队在设计tenferro-rs时,特别注重模块化和可扩展性。操作族被设计为独立的crate,自动微分规则与张量类型分离,后端和设备管理显式化。

这些设计使得tenferro-rs不仅适用于张量网络,还能够在更广泛的科学计算领域发挥作用。在实际应用中,tenferro-rs展现出了出色的性能。通过与PyTorch和JAX的基准测试对比,tenferro-rs在许多目标上达到了接近的性能水平。项目团队还建立了独立的正确性检查机制,确保代码的准确性。通过与有限差分和PyTorch参考结果的对比,tenferro-rs能够有效地验证其计算结果的正确性。此外,项目团队还建立了详细的设计文档和规则约束,确保代码的可维护性和可扩展性。
tenferro-rs的出现,标志着科学计算领域正在经历一场深刻的变革。随着AI技术的发展,编程语言的选择标准也在发生变化。在AI代码生成的时代,代码的正确性和可维护性比开发效率更为重要。Rust语言凭借其强大的类型系统和内存安全特性,成为科学计算领域的理想选择。tenferro-rs项目的成功,不仅展示了Rust在科学计算领域的潜力,也为其他领域的开发者提供了宝贵的经验和参考。随着科学计算领域的不断发展,tenferro-rs项目也在持续演进。
项目团队正在不断优化其性能,并扩展其功能。未来,tenferro-rs有望在更广泛的科学计算领域发挥重要作用,推动科学研究的进步。对于那些希望在Rust语言中获得类似PyTorch和JAX功能的开发者来说,tenferro-rs提供了一个强大的工具选择。随着项目的不断完善,tenferro-rs有望成为科学计算领域的重要工具之一,为研究人员和开发者提供更高效、更可靠的计算支持。 。