探讨 PostgreSQL 数据存储在 S3 的 Parquet 文件格式的 LTAP 架构设计,分析其优势、挑战及替代方案,为数据工程师提供技术参考
在数据工程领域,PostgreSQL 作为开源关系型数据库,以其强大的功能和稳定性广受欢迎。然而,随着数据量的爆炸性增长,传统的数据存储方式面临着性能和成本的双重挑战。近年来,将 PostgreSQL 数据存储在 S3 的 Parquet 文件格式中,并采用 LTAP(Lambda 存储架构)的架构设计,成为一种备受关注的解决方案。这种架构不仅能够充分利用云存储的优势,还能通过 Parquet 格式的高效压缩和列式存储特性,显著提升查询性能。本文将深入解析 LTAP 架构的核心设计理念,分析其在数据存储、处理和查询中的应用场景,并探讨其与传统架构的差异,为数据工程师提供技术参考。 在数据存储领域,S3 作为 Amazon 提供的对象存储服务,以其高可用性、低成本和无限扩展性,成为企业级数据存储的首选之一。
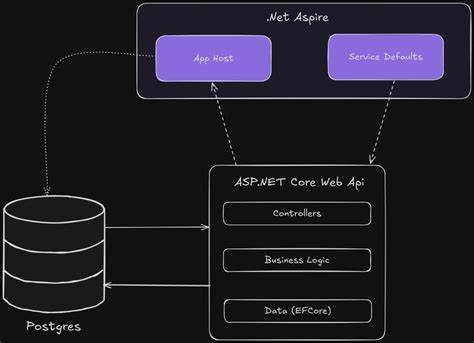
将 PostgreSQL 数据存储在 S3 的 Parquet 文件中,可以充分利用 S3 的低成本存储特性,同时通过 Parquet 格式的高效压缩和列式存储特性,显著减少存储空间和 I/O 开销。此外,Parquet 格式还支持分区和索引,使得数据查询更加高效。LTAP 架构则进一步优化了数据处理流程,通过 Lambda 架构的设计,将数据的批处理和实时处理分离,确保数据的实时性和准确性。 在 LTAP 架构中,数据的存储和处理流程主要分为三个层次:存储层、处理层和查询层。存储层负责将 PostgreSQL 数据导出为 Parquet 文件,并存储在 S3 中。处理层则负责数据的批处理和实时处理,通过 Spark 等分布式计算框架,对数据进行清洗、转换和聚合。
查询层则提供数据的查询接口,支持 SQL 查询和实时分析。这种分层设计不仅提高了系统的扩展性和灵活性,还能够根据业务需求,灵活调整数据处理流程。 然而,LTAP 架构在实际应用中也面临一些挑战。例如,数据的导出和导入过程可能会影响 PostgreSQL 的性能,特别是在数据量较大的情况下。此外,Parquet 文件的格式转换和压缩过程也可能增加系统的计算开销。为了解决这些问题,数据工程师需要在架构设计中进行优化,例如通过增量导出和并行处理,减少数据导出的影响。
同时,选择合适的压缩算法和分区策略,也能够显著提升数据处理的效率。 除了 LTAP 架构,市场上还有其他替代方案,例如 SeaweedFS、RustFS 和 Garage 等分布式文件系统。这些方案在数据存储和处理方面各有优势,例如 SeaweedFS 以其高可用性和扩展性著称,而 RustFS 则以其高性能和低延迟著称。数据工程师可以根据具体的业务需求,选择最适合的方案。 在未来,随着云计算和大数据技术的不断发展,LTAP 架构和其他替代方案将继续演进,为数据工程师提供更加高效和灵活的数据存储和处理方案。数据工程师需要密切关注行业动态,不断优化架构设计,以应对不断增长的数据挑战。
。