Martin Kleppmann经典论文中文解读,剖析CAP定理的定义误区与为何应停止使用CP/AP标签,介绍更精确的分布式系统一致性模型与权衡分析方法
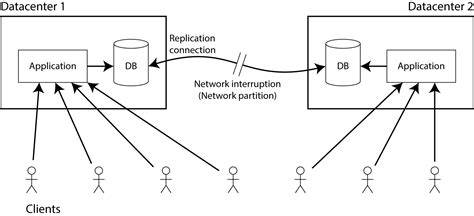
在分布式数据库的讨论中,CAP定理几乎成了绕不开的话题。开发者和架构师们习惯于将自己的系统贴上"CP"或"AP"的标签,仿佛这样就能清晰地描述其特性。然而,知名分布式系统专家Martin Kleppmann在2015年发表的一篇博文中尖锐地指出:这种标签化思维不仅简化得过分,更在本质上误导了我们对分布式系统的理解。 CAP定理的诞生与误用 CAP定理由Eric Brewer在2000年提出,它声称在分布式数据存储系统中,一致性(Consistency)、可用性(Availability)和分区容错性(Partition tolerance)三者只能择其二。这一定理在学术界和工业界引起了巨大反响,成为了分布式系统设计的"黄金法则"。 然而,十五年过去,这一定理却被广泛地误解和滥用。

Kleppmann在文中列举了多个令人深思的现象:许多系统被简单地归类为"CP"(在网络分区时保持一致性但牺牲可用性)、"AP"(在网络分区时保持可用性但牺牲一致性),甚至还有被称为"CA"的系统 - - Kleppmann讽刺地说,这类系统的作者显然没有读过Coda近五年前的那篇重要文章。 这种简单二分法的问题在于,它掩盖了分布式系统设计中真实而复杂的权衡关系。 CAP定义中的窄义陷阱 要正确理解CAP定理的局限性,首先需要明确其精确的数学定义。Kleppmann指出,定理的证明依赖于非常具体的定义,与日常使用中的含义存在巨大差异。 一致性在CAP中实际上指的是线性一致性(linearizability),这是一个非常特定且非常强的一致性概念。值得注意的是,这与ACID中的"C"(一致性)毫无关系,虽然两者都使用了"一致性"这个词。
线性一致性的核心思想是:如果操作B在操作A成功完成后才开始,那么操作B必须看到操作A完成时的系统状态或更新的状态。 可用性在CAP中的定义是"系统中任何非失败节点接收到的请求都必须产生非错误响应"。这要求不仅是某些节点能够处理请求,而是所有非失败节点都必须能够处理。许多号称"高可用"的系统实际上并不满足这个严格的定义。 分区容错性(这个命名本身就很糟糕)基本上意味着你正在使用一个可能延迟或丢失消息的异步网络。互联网和我们的所有数据中心都具有这个特性,所以在这件事上你实际上没有选择余地。

更关键的是,CAP定理描述的系统模型非常简单 - - 它只是一个单一的读写寄存器。定理根本没有涉及涉及多个对象的事务,也没有考虑网络分区之外的其他故障类型,如节点崩溃、磁盘空间耗尽、软件bug等。此外,CAP定理对延迟只字未提,但用户通常比可用性更关心延迟。 实际系统的复杂面貌 当我们用CAP定理的严格定义来审视实际的数据库系统时,会发现几乎没有任何系统能够被干净地归类为"CP"或"AP"。 以采用单主复制的传统关系型数据库为例,这是最常见的复制配置。在这种配置下,如果客户端与主节点隔离,就无法写入数据库。
即使它可以从从节点读取(只读副本),但无法写入意味着任何单主设置都不满足CAP的可用性定义。 但这是否意味着它是"CP"呢?更进一步说,如果允许应用从从节点读取,并且复制是异步的(大多数数据库的默认设置),那么从节点可能稍落后于主节点。这种情况下,读取不是线性一致的,因此不满足CAP的一致性定义。 所以这些系统既不是CAP一致的,也不是CAP可用的。它们既不是"CP"也不是"AP",只是"P" - - 无论那意味着什么。是的,"三选二"的表述确实允许你只选三个中的一个,甚至一个都不选! 再来看MongoDB,它每个分片都有一个主节点(或者至少应该如此,只要不处于脑裂模式),所以根据上面的论证它不是CAP可用的。
而研究人员Kyle Kingsbury已经证明,即使在最高一致性设置下,MongoDB也允许非线性一致的读取,所以它也不是CAP一致的。 Dynamo的衍生品如Riak、Cassandra和Voldemort通常被称为"AP",因为它们优化高可用性。但这取决于你的设置。如果你接受单副本读写(R=W=1),它们确实是CAP可用的。然而,如果你要求法定人数读写(R+W>N),并且存在网络分区,分区少数侧的客户端无法达到法定人数,所以法定人数操作不是CAP可用的。 ZooKeeper的启示 ZooKeeper是一个特别有趣的案例。
它使用共识算法,所以人们普遍认为它是一致性优于可用性的典型代表,即一个"CP系统"。 然而,仔细阅读ZooKeeper的文档会发现,它默认情况下并不提供线性一致的读取。每个客户端连接到其中一个服务器节点,当你进行读取时,你只能看到该节点上的数据,即使其他节点上有更新的写入。这使得读取比每次都要召集法定人数或联系主节点要快得多,但也意味着ZooKeeper默认不满足CAP定理的一致性定义。 可以通过在读取前调用sync命令来在ZooKeeper中实现线性一致的读取。但这不是默认设置,因为它会带来性能损失。
人们确实使用sync,但通常不是一直使用。 至于ZooKeeper的可用性,它需要多数法定人数才能达成共识,即才能处理写入。如果你有一个分区,多数节点在一侧,少数节点在另一侧,那么多数侧可以继续运行,但少数侧的节点无法处理写入,即使节点是正常运行的。因此,在分区情况下,ZooKeeper的写入不是CAP可用的。 有趣的是,ZooKeeper 3.4.0增加了一种只读模式,允许分区少数侧的节点继续提供读取服务 - - 不需要法定人数!这种只读模式是CAP可用的。因此,默认情况下ZooKeeper既不是CAP一致的(CP)也不是CAP可用的(AP) - - 它实际上只是"P"。
然而,你可以通过调用sync让它变成CP,而对于读取(但不是写入),如果你打开正确的选项,它实际上是AP的。 这确实令人恼火。仅仅因为ZooKeeper默认不是线性一致的,就称它"不一致",这严重歪曲了它的特性。它实际上提供了极好的一致性级别!它提供了原子广播(可归结为共识)结合因果一致性的会话保证 - - 这比"读己之写"、单调读和前缀一致读的总和还要强。文档说它提供顺序一致性,但这是低估了它,因为ZooKeeper的保证实际上比顺序一致性要强得多。 为什么二元分类注定失败 我们无法将任何一个数据存储明确归类为"AP"或"CP"这一事实,应该告诉我们一些事情:那些根本不是描述系统的正确标签。
Kleppmann认为我们应该停止将数据存储放入"AP"或"CP"桶中,原因有几个。首先,在同一软件中,你完全可能有各种不同一致性特征的操作。许多系统既不是CAP一致的也不是CAP可用的。然而,我从未听说过有人称他们的系统只是"P",大概因为这看起来很糟糕。但它并不糟糕 - - 它可能是一个完全合理的设计,只是不适合"CP/AP"两个桶中的任何一个。 其次,即使大多数软件不能整齐地适应这两个桶中的一个,人们还是试图将软件硬塞进其中一个桶,从而不可避免地将"一致性"或"可用性"的含义改变为适合自己的定义。
不幸的是,如果改变了这些词的含义,CAP定理就不再适用,因此CP/AP的区分变得完全毫无意义。 第三,通过将系统放入两个桶中的一个,失去了大量的细微差别。分布式系统设计中有许多关于容错、延迟、编程模型简单性、可操作性等方面的考虑。仅仅用一位信息是不可能编码这种细微差别的。 更值得注意的是,即使Eric Brewer本人也承认CAP是误导性的且过于简化的。2000年,它的目的是开启关于分布式数据系统权衡的讨论,它也确实很好地做到了这一点。
它不打算成为一个突破性的形式化结果,也不是数据系统的严格分类方案。十五年后的今天,我们有了更广泛的选择工具,具有不同的一致性和容错模型。CAP已经完成了它的使命,现在是时候向前看了。 寻找更精确的语言 如果CP和AP不适合描述和评判系统,那么我们应该用什么来代替呢?Kleppmann认为没有唯一正确的答案。许多人都深入思考过这些问题,并提出了术语和模型来帮助我们理解问题。要学习这些想法,你需要更深入地研究文献。
一个很好的起点是Doug Terry的论文,他用棒球比赛的例子解释了各种不同级别的一致性。即使你不是美国人,对棒球一无所知,这篇论文也非常易读易懂。 如果你对事务隔离模型感兴趣(这与分布式副本的一致性不是同一回事,但有些关联),那么Kleppmann的小项目Hermitage可能会有所帮助。 副本一致性、事务隔离和可用性之间的联系由Peter Bailis等人进行了探讨。他们的论文还解释了Kyle Kingsbury喜欢展示的一致性级别层次结构的含义。 当你读完这些后,你应该准备深入研究文献。
Kleppmann的文章中散布了大量论文链接。一定要看一看这些:许多专家已经为你解决了大量问题。 构建分布式系统的现实思考 Kleppmann的论点本质上是在呼吁分布式系统社区超越简单的标签思维,转向更精确、更细致的分析。CAP定理作为一个启发式工具可能还有其价值,但作为分类方案已经远远不够了。 当我们设计和选择分布式数据库时,应该考虑的具体问题包括:系统提供什么样的具体一致性保证?是否支持线性一致性、顺序一致性还是因果一致性?事务隔离级别是什么?系统如何处理网络分区?分区发生时哪些操作可用,哪些不可用?延迟特征如何?这些问题的答案远比一个"CP"或"AP"标签复杂得多。 此外,CAP定理只考虑了网络分区这一种故障,而实际系统可能面临各种故障模式:节点崩溃、磁盘故障、软件bug、配置错误、安全攻击等。
一个健壮的分布式系统设计需要考虑所有这些方面。 结语:超越标签的智慧 Martin Kleppmann这篇文章的核心信息很简单:停止用过于简化的标签来思考分布式系统。CAP定理有其历史价值,但用它来分类现代分布式数据库是误导性的,甚至是有害的。 真正的系统设计需要深入理解各种一致性模型、故障模式、性能特征和权衡取舍。这不是一件容易的事,需要耐心和好奇心。但回报是巨大的:学会推理权衡,从而找出最适合你特定应用架构的方案。
无论你选择哪种学习方式,Kleppmann都鼓励你保持好奇和耐心 - - 这些东西不容易理解。但这是值得的,因为你学会了推理权衡,从而找出最适合你特定应用架构的方案。但无论如何,请停止谈论CP和AP,因为它们毫无意义。 在这个技术快速迭代的时代,正确的思维方式比任何标签都重要。让我们超越简单的二分法,用更精确的语言和更深入的分析来理解和构建分布式系统。这才是技术进步的正确方向。
。