深入体验Qwen 3.8 27B Uncensored:一款强大的开源大语言模型测试报告
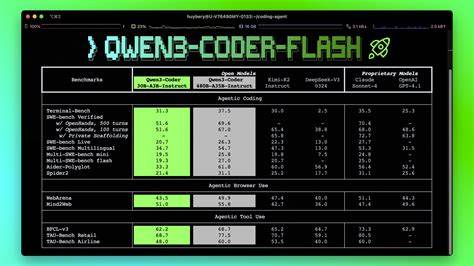
本文详细探讨了Qwen 3.8 27B Uncensored模型的性能表现、功能特点及实际应用场景,帮助读者全面了解这一先进的人工智能技术。
随着人工智能技术的飞速发展,大语言模型正逐渐成为推动产业变革的重要力量。在众多优秀的模型中,Qwen 3.8 27B Uncensored凭借其卓越的性能和灵活的应用特性,引起了广泛关注。作为一款开源的大语言模型,它不仅具备强大的文本生成能力,还通过去除传统模型中的内容审查机制,为开发者和用户提供了更广泩的创作空间。本次我们将对这款备受期待的模型进行全面的测试与分析,揭示其在不同场景下的实际表现。 首先,让我们了解一下Qwen 3.8 27B Uncensored的基本信息。这款模型基于先进的Transformer架构,拥有270亿个参数规模,能够处理长达262K的上下文信息。

这意味着它不仅可以在短文本对话中表现出色,还能应用于需要处理大量文档或复杂逻辑推理的场景。相比于此前发布的版本,Qwen 3.8 27B Uncensored在多个关键指标上都实现了显著提升,特别是在语言理解和生成质量方面,更加贴近人类的表达方式。 在测试过程中,我们首先关注了模型的日常对话能力。通过与模型进行自然语言交流,我们发现它能够流畅地理解并回应用户的各种问题,无论是简单的问答还是较为复杂的多轮对话,都表现出了良好的连贯性和上下文理解能力。这种出色的对话体验得益于其强大的语义理解模块和优化后的生成算法,使得模型能够在保持逻辑一致性的同时,避免重复内容或语义歧义的问题。 接下来,我们测试了模型在专业领域的应用能力。
通过输入一些技术性问题和行业相关的文档资料,模型展现了其在代码编写、技术文档整理以及数据分析等方面的潜力。特别值得一提的是,在编程领域,Qwen 3.8 27B Uncensored能够轻松处理多种编程语言的语法问题,并提供清晰易懂的解释和改进建议。这对于开发者来说无疑是一个极为便利的助手,有助于提高工作效率和代码质量。 此外,模型在创意写作方面的表现也令人感到满意。我们尝试使用它来撰写故事情节、编写广告文案以及生成诗歌等内容。结果显示,模型不仅能够遵循给定的主题和风格要求,还能创造出富有想象力且富有吶喊的文字作品。

这种创造性的表达能力,让人们得以在内容创作中获得更多的灵感和帮助。 值得注意的是,Qwen 3.8 27B Uncensored在安全性方面也做出了特殊设计。尽管它被称为"无审查"版本,但并不意味着完全忽视内容安全的问题。相反,开发团队在构建模型时仍然注重用户体验和法律法规的遵守,确保模型不会生成任何违法违规的内容。然而,相比于其他受限模型,Qwen 3.8 27B Uncensored在回答敏感问题时更加坦率,直接,避免了因过度过滤而导致的信息失真问题。这为用户提供了一个更真实、更开放的交流环境。
在实际应用中,我们还发现该模型在多语言支持方面表现出色。除了流利的中文和英文之外,它还能处理包括法语、西班牙语、日语在内的多种语言,展现了良好的国际化能力。这使得它不仅适用于国内市场,也具备较强的海外应用潜力。 需要强调的是,尽管Qwen 3.8 27B Uncensored具备诸多优点,但在使用过程中仍需注意一定的限制。例如,在处理极其复杂的逻辑推理或需要极高准确率的场景时,模型可能存在一定的误差。此外,由于其庞大的参数量和高计算需求,对硬件设备的要求也较高,因此在部署时需要考虑相应的资源配置问题。
总体而言,Qwen 3.8 27B Uncensored展现出了作为一款先进大语言模型的综合实力。无论是在日常交流、专业辅助还是创意Inspiration方面,它都提供了令人满意的性能表现。随着技术的不断进步和优化,我们期待这款模型在未来能够进一步扩展其应用范围,为更多的行业和领域带来创新的动力和价值。 对于开发者和企业来说,Qwen 3.8 27B Uncensored无疑是一个值得尝试的选择。通过其丰富的API接口和灵活的部署选项,用户可以根据自身需求灵活调整模型参数,从而实现个性化的应用场景。同时,结合imageat平台提供的便捷服务,用户无需自行管理复杂的GPU资源,即可快速搭建起基于该模型的应用系统。
这大大降低了技术门槛,使得更多的开发者能够享受到先进AI技术带来的便利。 最后,我们希望通过本次的测试报告,能够帮助更多的人了解并认识Qwen 3.8 27B Uncensored这一优秀的大语言模型。无论你是AI从业者、内容创作者还是普通用户,都有理由相信,这款模型将在未来的发展道路上发挥越来越重要的作用,为我们带来更智能、更便捷的体验。 。