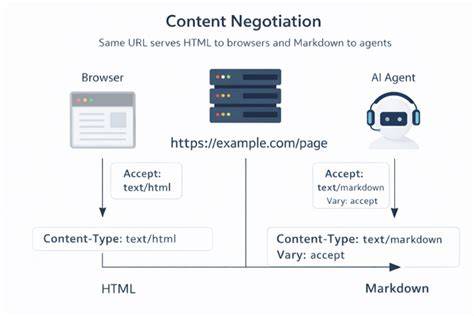
通过 HTTP 内容协商机制,使用 Accept: text/markdown 请求头,网站可为 AI 代理返回纯 Markdown 格式,提升信息提取与语义理解效率
在当今的互联网生态中,人工智能代理程序正以前所未有的速度渗透到信息检索、内容聚合和知识发现等各个领域。这些代理通常通过标准的 HTTP 协议与服务器交互,请求并处理返回的文档。默认情况下,服务器返回的往往是完整的 HTML 页面,其中包含大量的样式表、脚本、导航栏以及广告元素,这些内容对于人类用户而言是必要的,但对于追求高效率的 AI 代理却构成了冗余。代理在处理这类页面时,不得不进行复杂的 DOM 解析、去除噪声并提取有效文本,这不仅增加了处理时间,也消耗了宝贵的上下文窗口资源。因此,如何让服务器为 AI 代理提供一种更简洁、更易解析的表示形式,成为提升代理性能的关键因素。 HTTP 协议提供了内容协商机制,允许客户端在请求中通过 Accept 头部表明其期望的媒体类型。

服务器依据该头部信息,可以从多种表示形式中选择最合适的一种返回给客户端。对于 AI 代理而言,最常见的期望类型是 text/markdown,这是一种轻量级的标记语言,既保留了标题、列表、链接等结构化信息,又去除了 CSS 样式和 JavaScript 逻辑,使得文本内容更加紧凑且语义清晰。通过在请求中包含 Accept: text/markdown,代理可以明确告知服务器其偏好,服务器则可以根据该偏好返回相应的 Markdown 版本,从而实现内容的按需交付。 采用这种策略的好处显而易见。首先,Markdown 格式显著减少了传输的数据量,因为去除了大量的标签和属性,页面体积通常可以缩减至原始 HTML 的三分之一甚至更少。这不仅加快了网络传输速度,也降低了代理在接收和解析阶段的计算开销。
其次,Markdown 的结构化特性使得代理能够直接提取标题、段落、列表等语义单元,无需进行复杂的 HTML 解析,从而提高了信息提取的准确性和效率。此外,由于 Markdown 文本通常不包含广告、相关推荐或弹窗等干扰元素,代理生成的摘要或嵌入向量将更加纯净,提升了后续检索增强生成(RAG)等任务的效果。 要实现这一机制,开发者需要在服务器端进行适当的配置。以 Nginx 为例,可以利用 map 指令根据 Accept 头部的值选择不同的响应体。首先定义一个映射表,将 text/markdown 映射到一个特定的变量,然后在 location 块中根据该变量返回对应的静态文件或动态生成的内容。例如,可以将 Markdown 文件存放于 /markdown 目录,当请求头包含 text/markdown 时,Nginx 会自动重写内部请求至该目录,从而返回 Markdown 格式。

类似地,Caddy 虚拟主机可以通过 handle 指令和 rewrite 实现相同的功能,其简洁的语法使得配置过程更加直观。对于使用 Apache 的站点,可以利用 mod_rewrite 模块和 RewriteCond 指令,结合 Accept 头部进行条件重写。这些配置的核心思想都是根据客户端的 Accept 值进行内容路由,确保返回的表示形式与请求期望一致。 在实现过程中,还需要注意几个关键的 HTTP 头部。首先,服务器应当在响应中包含 Vary: Accept 头部,以告知缓存代理或 CDN 该响应的表示形式依赖于 Accept 请求头,避免不同客户端收到错误的缓存副本。其次,当服务器无法提供请求的媒体类型时,应当返回 406 Not Acceptable 状态码,并在响应体中列出支持的媒体类型,以便客户端进行后续协商。
此外,对于支持多种质量因子的 Accept 头部,服务器可以解析 q 值,优先返回质量最高的表示形式,如果客户端明确指定了 q=0,则可以忽略该类型并回退到默认格式。 缓存策略也需要相应调整。由于同一 URL 可能存在多种表示形式,缓存系统必须能够区分它们。通过在缓存键中纳入 Accept 头部的哈希值,或者利用 Vary 头部指示的维度,CDN 和反向代理可以正确地存储和检索不同版本的资源。同时,对于频繁访问的 Markdown 资源,可以设置较长的过期时间,以减少后端服务器的负载。对于动态生成的 Markdown 内容,可以考虑使用边缘计算函数在靠近客户端的位置实时生成,从而进一步降低延迟。
安全性方面,虽然提供多种表示形式通常不会引入新的漏洞,但仍需注意请求伪造和内容注入等风险。服务器应当验证 Accept 头部的合法性,避免被恶意构造的请求利用来绕过安全策略。此外,Markdown 内容在渲染为 HTML 时,需要进行适当的转义处理,防止跨站脚本攻击。对于包含敏感信息的页面,无论请求的媒体类型如何,都应实施严格的认证和授权机制。 测试是确保内容协商正确工作的重要环节。可以使用 curl 命令模拟不同 Accept 头部的请求,检查服务器是否返回预期的响应。
例如,执行 curl -H Accept: text/markdown https://example.com 应当获取到 Markdown 格式的正文,而不带该头部的请求则返回标准的 HTML。通过自动化测试脚本,可以覆盖多种 Accept 组合以及边界情况,如缺失 Accept 头部、包含多个媒体类型、带有 q 值等。此外,还可以利用浏览器的开发者工具查看请求和响应头部,验证 Vary 和 Content-Type 是否正确设置。 从生态系统来看,越来越多的 AI 代理框架已经开始原生支持 Accept: text/markdown。例如,某些检索代理在抓取网页时会自动附加该头部,以获取更易处理的文本。未来,随着语义网和结构化数据的发展,可能会出现更加丰富的媒体类型,如 application/ld+json 或 text/semantic-markdown,但 Markdown 由于其简洁性和广泛支持,仍将是 AI 代理首选的表示形式之一。
网站运营者应当尽早适配这一需求,为 AI 代理提供友好的接口,从而在智能搜索和知识图谱构建中获得更好的曝光和理解。 在实际部署中,不同的服务器平台提供了各自的工具来简化这一过程。对于使用 Cloudflare Workers 的站点,可以在 Worker 脚本中检查请求头,若发现 Accept 包含 text/markdown,则通过 fetch 函数从源服务器获取预生成的 Markdown 文件,或者利用 Workers 内部的模板引擎动态生成内容。这种边缘计算的方式能够显著降低延迟,因为 Markdown 内容可以在靠近用户的节点上生成和返回。对于采用 WordPress 的博客,可以利用现有的插件或自定义钩子,在主题函数中判断 Accept 头部,并输出相应的 Markdown 格式。例如,通过在 functions.php 中添加 action 钩子,当检测到特定的 Accept 值时,可以调用 wp_export 或直接输出 get_post 的 Markdown 表示。
类似地,Discourse 论坛可以通过修改 app/models/post.rb 或使用自定义序列化器,为 API 端点提供 Markdown 响应。对于 Laravel 应用,可以在中间件中解析 Accept 头,并根据需要切换视图引擎,返回 Blade 编译后的 Markdown 字符串。Ruby on Rails 则可以通过自定义渲染器或使用 gem 如 rails-markdown 来实现相同的功能。这些方案的核心思想都是在请求处理的早期阶段识别客户端的媒体类型偏好,从而动态选择合适的表示形式。 性能优化方面,除了减少传输数据量外,还可以通过压缩算法进一步提升效率。由于 Markdown 文本通常为纯文本,使用 gzip 或 brotli 压缩可以显著降低带宽消耗。
服务器应当在响应中包含 Content-Encoding: gzip 头部,并确保压缩级别适中,以平衡 CPU 使用和压缩比。对于频繁访问的静态 Markdown 文件,可以启用 HTTP 缓存控制头,如 Cache-Control: public, max-age=86400,使中间件能够缓存响应,减少源站压力。对于动态生成的 Markdown,可以考虑使用 stale-while-revalidate 策略,在后台更新缓存的同时,先返回旧的版本,保证低延迟。 监控和日志记录也是不可或缺的一环。通过收集请求中的 Accept 头部分布,可以了解哪些客户端正在使用内容协商功能,从而评估其实际效果。服务器日志应当记录每个请求的 Accept 值、响应状态码以及返回的 Content-Type,以便在出现 406 错误时进行排查。
此外,可以设置指标,如 Markdown 响应的平均大小、缓存命中率以及延迟变化,用于持续优化配置。 从标准化角度来看,RFC 7763 详细描述了如何在 HTTP 中使用 Accept 头部进行内容协商,而 RFC 9110 则对 HTTP 语义进行了更全面的规范。遵循这些标准可以确保不同实现之间的互操作性。同时,text/markdown 媒体类型在 IANA 注册,具有明确的定义和使用指南,开发者在实现时应参考相关文档,以避免常见的陷阱,如错误的字符集声明或不兼容的扩展。 未来,随着人工智能代理对语义理解要求的提高,可能会出现更高级的标记语言,例如结合了实体链接和上下文信息的语义 Markdown。现有的 Markdown 解析器可以扩展以支持这些新特性,同时保持与标准 Markdown 的兼容性。
网站开发者应当保持对新兴标准的关注,并在适当时机引入新的媒体类型,以提供更丰富的语义表示。 总之,通过 Accept 头部实现 Markdown 内容的按需交付,不仅是一项技术优化,更是构建人机友好型网络生态的重要一步。它使得网站能够同时服务于人类用户和智能代理,提升了信息的可访问性和可处理性。随着 AI 技术的持续演进,这种基于标准协议的协作模式将在未来的智能互联网中扮演核心角色。 。