PostgreSQL随机页面成本参数深度解析:超越I/O成本的代价模型思考
深入探讨PostgreSQL中random_page_cost参数的真实含义,揭示其作为内存使用与缓存效应代理变量的本质,提供针对不同存储环境的调优思路与实践方法。
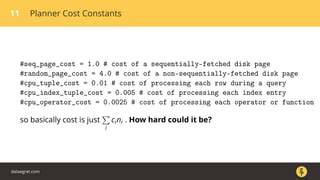
在数据库性能优化的广阔领域中,PostgreSQL的查询优化器长期依赖一组精妙的成本估算参数来做出执行计划决策。其中,random_page_cost作为衡量随机I/O相对顺序I/O代价的关键参数,自PostgreSQL诞生之初便承载着优化器对存储访问模式的理解。然而,随着存储技术的飞速演进,从早期的机械硬盘到如今普遍采用的固态硬盘,这一参数的默认值是否仍然合理,成为了社区热议的话题。 回顾random_page_cost的历史渊源,我们不得不提及千禧年前后那次奠定默认值的基础实验。彼时的存储环境以机械磁盘为主,无论PATA还是SCSI接口,磁盘寻道时间与旋转延迟共同构成了随机访问的主要开销。在这样的硬件条件下,随机I/O相较于顺序I/O往往产生四倍左右的性能差距,这便是4.0这一经典默认值的历史依据。

然而正如业界专家Tomas Vondra通过实际测试所揭示的,即便使用如今看来已属古董的SATA旋转磁盘,测得的随机页面成本估算值仍高达125左右,约为固态硬盘环境下的两到四倍。这一发现有力地表明,4.0的默认值从来都不是随机I/O的原始成本数字,而是经过某种调整后的产物。 面对这一历史遗留问题,众多经验丰富的数据库管理员曾尝试通过提高random_page_cost值来使其更贴近理论上的随机I/O成本。然而实践结果却令人困惑:这种调整非但未能提升性能,反而常常导致系统表现下滑。这种现象的背后蕴含着对PostgreSQL成本模型本质的深刻理解。random_page_cost并非单纯描述I/O的物理开销,而是充当着一个更为复杂的角色 - - 它是对成本模型固有缺陷的补偿机制。
PostgreSQL的成本模型本质上是一种经过权衡的近似方案。它需要在计算开销与模型精度之间找到平衡点,既不能过于简化以至于丧失指导意义,也不能过于复杂以至于在规划阶段消耗过多资源。这种设计哲学决定了成本模型必然存在若干盲区,而random_page_cost正是用来弥补这些盲区的工具。 在所有模型缺陷中,对内存资源的忽视尤为关键。当前的成本计算主要考量CPU与磁盘I/O两类资源,却将内存这一关键因素排除在外。工作内存参数虽然存在,但它本质上只是一个安全阈值,用于限制排序与哈希等操作的缓冲区大小。

虽然它会间接影响I/O需求 - - 例如较小的哈希缓冲区会导致更多磁盘溢出 - - 但它并未真正追踪计划执行过程中所占用的内存总量。 考虑一个典型的查询场景:面对一张百GB级别的数据表,其中仅包含1GB符合查询条件的数据。优化器面临两种选择:通过索引进行随机访问,或者进行全表顺序扫描。从纯粹的I/O成本角度计算,顺序扫描可能确实更具优势,尤其是当表数据完全冷启动的情况下。然而顺序扫描在执行过程中会将约100GB的其他数据推入内存,挤占共享缓冲区或操作系统页面缓存中的现有内容。即便查询本身只需4MB的工作内存,它实际上却消耗着百GB级别的内存资源。
相比之下,索引扫描虽然需要付出随机I/O的物理代价,但只需访问约1%的数据量,对内存的侵占也微乎其微。这种差异在并发环境下尤为显著 - - 当多个查询同时执行时,顺序扫描可能迅速耗尽可用内存,引发大量换页操作,而索引扫描则能更好地维持系统的整体性能。 除了内存因素,访问局部性是另一个被成本模型忽视的重要维度。实际生产环境中的数据库系统通常存在所谓活跃数据集的概念:尽管整个数据库可能达到TB级别,但真正频繁访问的数据往往只占其中很小一部分。用户可能只关注最近的订单记录,最近的日志条目,这种业务特性使得数据访问呈现出明显的局部性特征。 随机I/O密集型的执行计划,如索引扫描,往往具有更强的访问局部性。
它们通常只访问真正感兴趣的数据片段,虽然单次访问成本较高,但总量可控。而顺序扫描则可能将整个数据库纳入活跃数据集,特别是在数据冷启动的情况下,可能导致数据库有效工作集急剧膨胀。理想情况下,系统应当将活跃数据集完整保存在内存中,以避免频繁的磁盘交换。索引扫描允许维持更小的活跃数据集,这正是其长期价值的体现。 遗憾的是,当前的优化器对活跃数据集这一概念缺乏认知。它假设每次查询都从完全冷启动的数据开始执行,仅在极个别情况下考虑缓存效应 - - 例如同一查询内部的预读优化。
优化器同样忽视查询间的相互影响,它在规划阶段假设资源无限且无竞争,将每个查询作为独立的个体进行评估。这种简化在单查询场景下或许可行,但在并发环境中可能导致次优决策:当一百个后端进程同时进行顺序扫描时,存储带宽将迅速成为瓶颈。 基于上述分析,我们应当将random_page_cost重新理解为多重效应的综合代理变量。它不仅反映随机I/O的物理成本,更承载着对内存使用与缓存行为的隐式考量。降低这一参数值会引导优化器选择更具局部性的执行计划,从而有效控制活跃数据集的规模。从长期系统健康的角度来看,这种策略往往能够带来更优的整体性能。
这一认知对实际调优工作具有重要指导意义。不存在某个通用工具能够通过简单的I/O基准测试得出适合特定系统的random_page_cost理想值。因为该参数的真正价值并不在于准确描述存储硬件的物理特性,而在于它对整体执行计划选择倾向的调节作用。正确的调优方法必然是系统特定的,需要结合实际监控数据进行反复验证。 一个值得推荐的调优思路是从pg_stat_statements扩展提供的顶级查询分析开始。通过识别系统中执行频率最高或资源消耗最大的查询,可以初步评估降低random_page_cost可能带来的影响。
对于那些通过索引访问少量数据的查询,降低该参数值可能促使优化器更倾向于使用索引,从而减少不必要的全表扫描。在做出调整后,需要持续监控系统整体性能,观察查询延迟、缓存命中率、I/O负载等关键指标的变化,确保优化效果符合预期,同时警惕可能对其他查询类型造成的负面影响。 值得一提的是,PostgreSQL社区正在积极探索成本模型的改进方向。AIO预取技术的引入为重新审视随机I/O成本提供了新的契机,预取机制能够有效隐藏随机访问的延迟,使得顺序扫描与随机扫描之间的性能差距进一步缩小。这些技术演进可能会在未来改变random_page_cost参数的最佳实践,但当前阶段,理解其作为内存与缓存效应代理变量的本质,对于做出明智的调优决策仍然至关重要。 总之,random_page_cost的调优不应被视为简单的参数数值调整,而应被理解为对优化器行为倾向的精细调控。
它要求数据库管理员深入理解工作负载特性,审慎权衡不同执行计划的长期影响,并通过持续的监控与实验找到最适合特定环境的平衡点。这种系统化的调优方法,正是PostgreSQL性能优化的精髓所在。 。