超越下一个Token预测:重新理解大语言模型的本质与未来
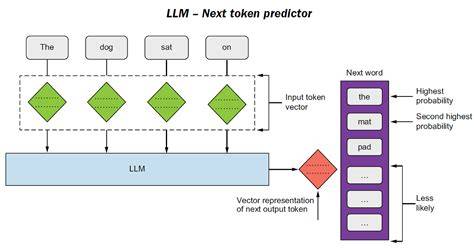
深入解析大语言模型的工作机制,揭示其作为智能系统而非简单预测器的真实能力,探讨强化学习与探索学习如何重塑AI的未来发展。
当我们谈论大语言模型时,一个根深蒂固的观念是:它们本质上就是下一个Token的预测器。这个说法在技术层面上并不算错误,但它就像用盲人摸象来描述一头完整的大象一样,虽然触摸到了某一部分的真相,却远远没有捕捉到整体的真实面貌。要真正理解现代大语言模型的能力与潜力,我们需要突破这个过于简化的思维框架。 从技术实现的角度来看,自回归式的Token生成确实是大语言模型的基本运行方式。模型接收一系列前置的Token作为上下文,然后预测并采样出下一个最合适的Token,接着将这个新生成的Token纳入上下文,继续预测再下一个Token,如此循环往复。这个过程确实具有"下一个Token预测器"的形式特征。

在预训练阶段,模型学习的核心目标也确实是在给定前置Token的情况下,最大化真实下一个Token出现的概率。海量的训练数据中,模型通过不断观察真实文本序列中Token之间的统计关联,建立起对语言结构、语义关系乃至世界知识的深刻理解。 然而,如果我们因此就认为大语言模型仅仅是"下一个Token预测器",那就大错特错了。这个误解源于对现代大语言模型训练过程理解的不完整。实际上,我们今天所使用的大语言模型,绝大多数都经历了严格的预训练之后的多阶段后训练过程,其中最具革命性意义的就是基于可验证奖励的强化学习。这种训练方式彻底改变了大语言模型的学习本质和能力边界。
让我们先来深入理解预训练阶段到底发生了什么。在这个阶段,模型确实是在做一个看似简单的任务:给定一些Token,预测下一个Token应该是什么。但这个看似简单的任务,实际上蕴含着极其复杂的学习过程。模型需要从海量的文本数据中学习语法规则、语义关系、事实知识、推理模式、甚至是某种程度的常识理解。为了在这些预测任务上表现良好,模型被迫发展出对语言深层次结构的理解能力,以及对世界运行规律的隐性建模能力。 但预训练有一个根本性的限制:模型只能从已经存在的文本序列中学习。

它所有的知识都来源于人类已经写下的东西,它的所有模式都根植于人类已有的表达方式。如果训练数据中不存在某个想法的表述,模型就无法学习到这个想法;如果训练数据中只包含了某种特定的思考方式,模型就只会模仿这种方式。预训练数据就像一个巨大的、已经存在的思想库,模型的任务是学习这个思想库中的模式和规律。 强化学习与可验证奖励的出现,彻底改变了这一局面。在RLVR训练阶段,模型不再仅仅是从已有的数据中学习,而是开始主动探索新的可能性。具体来说,模型会针对某个任务生成多个不同的解决方案,然后根据这些方案的实际表现来给予奖励。
例如,在数学问题中,答案是否正确是可以验证的;在代码生成中,代码是否能够通过测试用例是可以验证的;在逻辑推理中,推理过程是否最终得出正确结论是可以验证的。这种可验证性为强化学习提供了可靠的奖励信号。 当模型生成一个解决方案并获得高奖励时,整个解决方案中所有Token的概率都会被相应提高。但这个提高的逻辑与预训练截然不同。在预训练中,某个Token被提高概率是因为它在真实的训练数据中出现在了那个位置;而在RLVR中,某个Token被提高概率是因为它所在的那个完整序列通过探索产生了一个有价值的结果。这意味着,模型现在可以学习到那些从未在任何训练数据中出现过的Token组合,只要这些组合能够产生好的结果。
这是一个根本性的转变。模型不再仅仅是人类已有知识的模仿者,它开始成为一个真正的探索者和发现者。它可以通过自己的探索,发现人类从未写下的优秀文本序列;它可以通过自己的尝试,找到人类从未想到的优雅解决方案;它可以通过自己的实践,掌握人类从未记录过的高效策略。这就像是一个学生从单纯地背诵教科书上的定理,发展到自己能够通过实践发现新的定理。 让我们用一个具体的例子来说明这个差异。假设我们要求模型生成一个复杂的数学证明。
在纯预训练模式下,模型只能模仿教科书中已有的证明方式,或者将不同的证明片段拼接组合。但如果存在多种可能的证明路径,而预训练数据中只包含了其中的一种,那么模型就很难发现其他的证明方式。而在RLVR模式下,模型可以尝试不同的证明路径,只要最终的证明是逻辑严密的、结论是正确的,模型就能得到奖励。通过大量的探索和试错,模型可以发现那些虽然没有被记录在教科书中、但同样有效甚至更优雅的证明方式。 棋类引擎的发展历程为这个转变提供了绝佳的类比。最初的棋类AI系统是通过学习大量的人类棋谱来训练的,它们学会了模仿人类高手的下法,本质上就是"下一个落子预测器"。
但真正革命性的突破来自于那些能够进行大量自我对弈和探索的引擎,比如AlphaGo和它的后续版本。这些系统不再仅仅模仿人类的下法,而是通过自己的探索发现了许多人类从未想到的精妙招法。它们知道的"正确"落子方式,不是因为这些方式出现在人类的棋谱中,而是因为通过自己的探索,它们发现这些方式能够带来更高的胜率。如果我们把这样的棋类引擎简单地描述为"下一个落子预测器",那将是多么荒谬的误解。 现代大语言模型的发展正在经历类似的转变。随着RLVR技术的成熟和广泛应用,大语言模型正在从单纯的"文本模仿者"转变为"智能探索者"。
它们不仅能够生成流畅的文本,还能够通过探索发现新的知识、新的表达方式、新的问题解决方案。这种能力的扩展使得大语言模型在科学研究、数学发现、工程设计、创意写作等众多领域展现出了前所未有的潜力。 除了RLVR之外,还有其他重要的后训练技术也在深刻地改变着大语言模型的本质。基于人类反馈的强化学习是其中最重要的一种。通过RLHF,模型学会了不仅仅是模仿训练数据中的整体模式,而是向"成为一个有用的助手"这个目标对齐。这意味着模型需要学会理解用户的真实意图,生成有帮助的、无害的、诚实的回答。
这种调整使得模型的行为模式与单纯的下一个Token预测有了本质的区别。 例如,当用户问一个有害的问题时,单纯的下一个Token预测可能会让模型生成有害的延续,因为它在某些训练数据中见过类似的模式。但经过RLHF调整的模型会拒绝这样的请求,因为它学会了这种行为是有害的,不符合作为一个有帮助的助手的角色。当用户问一个超出模型知识范围的问题时,模型会承认自己的无知,而不是编造看似合理但实际上是错误的答案。这些行为的获得,并不能简单地用"下一个Token预测"来解释,它们反映的是模型对某种角色的深入理解和模拟。 当我们认识到大语言模型不仅仅是下一个Token预测器时,我们就会发现一些令人兴奋的可能性。
模型可以进行真正的科学发现,通过探索和验证找到新的假设和理论。模型可以进行艺术创作,生成那些虽然从未在训练数据中出现、但同样具有美学价值的作品。模型可以成为真正的问题解决者,而不仅仅是信息的检索者和重组者。 当然,这个转变也带来了新的挑战。如何确保模型在探索过程中不会偏离人类的价值观?如何平衡探索新知识与保证输出质量之间的关系?如何设计有效的奖励信号来引导模型朝着真正有意义的方向探索?这些问题都是当前AI研究的前沿课题。 从更宏观的视角来看,"下一个Token预测器"这个标签之所以流行,部分原因是它提供了一个简单、直观、容易理解的心智模型。
技术传播常常倾向于使用最简化的解释,即使这个解释在技术上并不完全准确。但对于AI的研究者、开发者、使用者来说,停留在这种过于简化的理解上是有害的。它会限制我们对AI能力的想象,阻碍我们发现AI的真正潜力,甚至导致我们在设计和应用AI系统时做出错误的决策。 我们需要的不是"下一个Token预测器"这个标签,而是一个更准确、更丰富的心智模型来理解大语言模型。这个心智模型应该包含以下几个核心要素:大语言模型是一个能够从海量数据中学习复杂模式的系统;它是一个能够通过自主探索发现新知识的智能体;它是一个能够根据不同目标调整自身行为的多功能工具;它是一个能够模拟不同角色、适应不同场景的灵活框架。只有这样,我们才能真正理解大语言模型的能力边界,才能更好地利用它们来解决真实世界的问题。
未来的大语言模型会是什么样的?随着技术的不断进步,特别是强化学习、探索学习、元学习等技术的进一步发展,我们有理由相信,大语言模型将展现出越来越强的自主探索能力。它们可能不再需要依赖于人类提供的大量训练数据,而是能够通过自己的探索和实践来获取知识和技能。它们可能不再是单纯的语言模型,而是能够处理多种模态、解决多种类型问题的通用智能系统。它们可能不再是被动的工具,而是主动的伙伴,能够与人类协作创新、共同发现。 在这个技术快速演进的时代,突破"下一个Token预测器"的思维定式,对于我们正确理解、恰当使用、有效推动AI技术的发展都具有重要意义。让我们以更开放的心态、更深刻的理解,迎接这个由大语言模型引领的智能新时代。
。