探索 Google Research 最新开发的 TabFM 模型,了解其零样本学习能力、表格数据处理优势及在分类与回归任务中的应用场景,为数据分析领域带来的革命性变革。
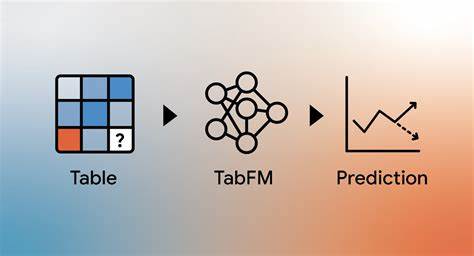
在人工智能领域,表格数据分析一直是一个具有挑战性的任务。传统方法往往需要大量的数据预处理和模型调参,而 Google Research 近期推出的 TabFM(表格基础模型)则打破了这一局限。作为首个零样本表格基础模型,TabFM 无需针对特定数据集进行微调,仅通过上下文学习即可实现高效的分类和回归预测。本文将深入解析 TabFM 的核心技术、应用场景及其对数据分析领域的影响。TabFM 的核心创新在于其独特的架构设计。模型采用交替的行和列注意力机制,既能捕捉特征间的交互关系,又能提取行级别的模式。
具体而言,列注意力通过集合变换器(Set Transformer)对每个单元格进行嵌入,并通过诱导自注意力聚合行数据。行压缩则利用旋转位置嵌入(RoPE)将每一行压缩为密集向量。在上下文学习(ICL)变换器阶段,24 层因果变换器处理这些压缩后的行向量,将训练行作为上下文,直接输出测试行的预测结果。这种设计使得 TabFM 能够在单次前向传播中完成预测,大大提升了模型的效率和灵活性。在数据训练方面,TabFM 采用了大规模合成数据集,基于结构因果模型(SCMs)动态生成。这种方法不仅避免了真实数据的隐私和版权问题,还为模型注入了关于因果结构和特征关系的归纳偏置。
通过这种方式,TabFM 能够在多样化的表格数据任务中表现出色。在 TabArena 平台的 51 个数据集评估中,TabFM 在零样本模式下超越了经过大量调参的梯度提升树等传统基线模型。TabFM 的应用场景广泛,尤其适合处理包含混合数值和分类列的结构化数据。在分类任务中,模型支持二元和多类分类(最多 10 类),而在回归任务中则能够处理连续目标变量。用户只需将训练数据作为上下文输入,即可直接进行预测,无需进行数据集特定的训练或超参数搜索。这种零样本学习能力使得 TabFM 特别适合快速原型开发和探索性数据分析。
然而,TabFM 也存在一些限制。首先,模型在分类任务中最多支持 10 类,这是由其架构决定的硬性限制。其次,内存使用量会随着训练行数的增加而线性增长,因为所有行都作为上下文被传递。此外,模型在处理非常宽的表格数据时可能表现不佳,因为其优化针对的是 500 个特征以内的表格。尽管 TabFM 在许多任务中表现出色,但其性能可能无法在所有数据集上超过经过任务特定微调的模型。在伦理考虑方面,TabFM 完全基于合成数据训练,因此其在特定真实世界领域、少数群体或边缘分布上的表现尚未完全评估。
用户在将模型部署到高风险场景之前,应当在代表性的保留数据集上进行充分评估。此外,TabFM 并非 Google 的官方支持产品,用户在使用时应注意其商业许可限制。总体而言,TabFM 的推出标志着表格数据分析领域的重要突破。其零样本学习能力和高效的架构设计为数据科学家和分析师提供了强大的工具。随着 TabFM 的进一步发展和优化,相信它将在更多的实际应用中发挥重要作用,推动数据分析领域的进步。 。