深入解析三星LPDDR5X-PIM内存内计算技术,探索614GB/s内部带宽如何突破传统内存带宽瓶颈,以及这项技术对本地大语言模型推理的重大意义和面临的软件生态挑战。
内存内计算革命正在悄然改变人工智能硬件的格局。三星在2026年Hot Chips大会上展示的LPDDR5X-PIM技术,首次将计算单元直接嵌入到商品内存芯片内部,在一个标准的16GB内存封装中实现了高达614GB/s的银行级带宽。这一数字与苹果M5 Max统一内存系统的峰值带宽相当,但却是通过完全不同的技术路径实现的。传统DRAM的外部接口只能提供76.8GB/s的带宽,而内部带宽却是其八倍之多,这种巨大的差距揭示了内存带宽瓶颈的本质,也指明了突破的方向。 理解这项技术需要先厘清几个核心概念。在传统计算机架构中,处理器需要从内存中读取数据才能进行计算,数据必须通过狭窄的内存总线在处理器和DRAM之间来回传输。

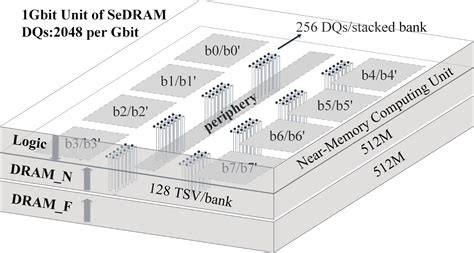
这种架构在处理高带宽需求的工作负载时效率极低,尤其是当计算操作本身相对简单但数据量巨大的情况下。矩阵运算是这类工作负载的典型代表,大语言模型的推理过程本质上就是不断重复地从内存中读取权重参数,进行一次乘法运算后立即丢弃,然后等待下一个token的生成。这种工作模式使得 arithmetic intensity 即算术强度处于极低水平,系统的性能瓶颈完全取决于内存带宽而非计算能力。 内存内计算的核心思想是将计算单元放置在DRAM银行旁边,使其能够直接利用银行级别的内部带宽而不是依赖外部接口。三星的设计在每个内存银行旁边放置了十六个PIM计算模块,每个模块包含并行运行的MAC运算树和负责浮点及整数类型运算的ALU单元。这种设计的关键优势在于权重数据可以始终保留在内存封装内部,只有体积小得多的激活数据需要穿越外部总线,而主机只需要向PIM模块发送控制命令即可完成运算。
从技术规格来看,三星LPDDR5X-PIM支持多达十五种精度组合。通过MAC精度字段的配置寄存器,系统可以在不同精度模式之间切换。SINT4权重配置下可达到2.4TOPS的算力,而FP8精度则能提供约1.2TFLOPS的单封装计算能力。这种灵活性使得该技术能够适应不同的应用场景和精度需求。 三星采用了一种名为地址对齐模式的兼容性机制,使得这款PIM内存可以使用传统DRAM控制器进行操作。系统通过预定义的行地址和PIM寄存器在单银行模式和多银行模式之间切换,这种设计避免了要求每个SoC厂商都必须开发全新内存控制器的尴尬局面。

传统控制器可以通过发送特定的命令序列来启用或禁用PIM功能,从而在普通内存模式和内存计算模式之间无缝切换。这项创新极大地降低了PIM技术的部署门槛。 在真实芯片测试中,三星展示了令人印象深刻的性能数据。在其边缘AI加速器SoC上运行的Llama 3.1 8B模型测试中,使用320个token的上下文长度,采用SINT8激活、SINT4权重和SINT32输出的量化配置,普通LPDDR5X的运行时间为12.3秒,吞吐量仅为27 tokens每秒。而启用LPDDR5X-PIM后,运行时间缩短至5.4秒,吞吐量提升至81.3 tokens每秒,性能提升达到三倍。需要指出的是,这个 vendor benchmark 仅覆盖了单一模型、单一短上下文和单一加速器配置,且全程使用整数量化,因此不应将其视为普遍适用的性能预测。
320个token的测试上下文长度相对较短,这意味着KV缓存带来的带宽竞争被控制在较低水平。 内存厂商积极推动PIM技术发展的根本原因在于成本考量。根据三星在演讲中展示的数据,内存占AI芯片组件支出的比例从2024年第一季度的52%增长到2025年第四季度的63%,其中HBM占据了增长的大部分。LPDDR5X-PIM为客户提供了一条通往HBM级别推理带宽的替代路径,却无需承担HBM的高价格、高功耗和复杂的封装要求。三星从2021年的Aquabolt-XL HBM2-PIM概念验证开始就在追求这一目标,LPDDR5X-PIM是其首个实现产品化的基于LPDDR的PIM设计。 然而,通往广泛采用的道路上横亘着三座主要障碍,这些障碍全部属于软件范畴而非硬件限制。
目前主流的推理运行时如llama.cpp、vLLM等都尚未支持PIM后端,三星目前仅提供模拟器、索取式提供的数据手册以及包含参考工具的SDK。 第一个挑战是量化格式的映射问题。llama.cpp之所以能够在质量与比特率之间取得优异平衡,很大程度上归功于GGUF格式中的k-quants如Q4_K_M等高级量化方案。这些格式采用块级量化,配备每块独立的缩放因子和超块级缩放因子。CPU和GPU可以在附近通用ALU上执行每块少量的去量化操作。然而DRAM芯片内部几乎没有通用逻辑电路,PIM MAC单元必须保持精简以适应DRAM制造工艺的特殊限制。
DRAM工艺优化的是存储电容而非逻辑晶体管,增加的每个晶体管都会降低存储密度。研究表明,主流量化方案需要在MAC单元之上额外增加缩放和控制硬件,这会带来约126%的面积开销。这种开销对于追求高存储密度的内存芯片来说是难以接受的。三星的十五种精度模式采用均匀量化格式,包括测试中使用的SINT4和SINT8组合,但并不实现Q4_K_M等复杂格式。现有的GGUF文件需要进行重新量化,转换成PIM原生格式,但目前尚不清楚k-quants的质量优势能在多大程度上保留到新的量化方案中。 第二个挑战涉及物理内存布局。
操作系统通过mmap机制允许内核将页面分散映射到物理DRAM的不同位置。但PIM计算需要对权重矩阵进行连续的、针对特定银行对齐的物理地址分配,因为PIMX_RD指令需要从特定位置的DRAM单元读取32字节的权重元素,并将其映射到对应的MAC树进行运算。只有当数据恰好位于预期位置时,这种读取和映射机制才能正常工作。这就需要操作系统提供支持大页面的、感知银行布局的内存分配器,并将其暴露给用户空间。当前macOS、Linux和Windows都没有提供这样的接口。llama.cpp令人称道的内存映射模型加载功能与这一要求形成了直接冲突。
第三个挑战是PIM架构与不同计算模式的匹配问题。当前的近银行设计包括三星的HBM2-PIM、SK海力士的GDDR6-PIM以及LPDDR5X-PIM,都将目标锁定在GEMV即矩阵向量乘法上。这种设计选择非常契合批大小为1的解码场景,因为此时带宽墙的影响最为严重。然而现代推理工作负载在纯GEMV和密集GEMM即矩阵矩阵乘法之间存在广阔的中间地带。批处理会将多个查询的GEMV操作合并成GEMM,分组查询注意力则将多个GEMV合并成窄GEMM,而投机解码因为需要并行验证草稿token,同样将GEMV转换为GEMM。这些操作提高了算术强度,但往往仍然不足以让GPU保持繁忙状态。
分组查询注意力出现在大多数当前模型中,投机解码也日益普及,这些趋势都会削弱针对GEMV优化的PIM设计的效率。对于小型批处理本地服务场景来说,这个问题同样存在。研究表明,投机解码中的验证步骤会将大线性层从GEMV推向窄GEMM,内存银行内的MAC单元仍然可以完成部分受内存限制的工作,但无法在这种更宽的操作上充分利用银行级别的吞吐量。三星当前设计在PIM运行期间还会阻塞NPU访问DRAM,阻止两个处理器并发处理同一层的不同部分。 多token预测技术的发展进一步凸显了这些限制。多token预测可以在训练中作为辅助目标使用,如DeepSeek-V3所做的那样,然后在普通推理时丢弃额外的预测模块。
另一种用途是在推理时将这些模块作为投机解码器使用,由它们提出若干未来token,然后由主模型并行验证这些候选。在Google的报告中,Gemma 4使用这种方法可获得高达三倍的加速。但这种验证步骤恰好暴露了三星当前设计的弱点,因为它改变了线性层的计算性质。 混合专家模型带来了额外的复杂性。路由机制将token发送到专家子集,如果这些专家恰好占据部分银行的权重,那么某些银行会成为热点而其他银行则闲置。动态工作负载还创造了不断变化的GEMV到GEMM比例,进一步降低了硬件利用率。
面对这些挑战,计算机架构研究人员已经探索了多种应对策略。一种是将工作负载进行分工,由AttAcc、IANUS和NeuPIMs等方案让NPU负责计算密集的预填充GEMM,而将内存密集的解码GEMV交给PIM处理。另一种思路是将计算单元移动到逻辑管芯上,如Duplex架构针对MoE、GQA和连续批处理进行了优化,在HBM逻辑管芯上放置了32个GEMM模块,每个模块配备512个FP16 MAC和一个8KB缓冲区。这些模块总共消耗17.80平方毫米,约占121平方毫米HBM3芯片面积的14.7%。逻辑管芯有足够的空间来容纳真正的GEMM单元,而内存银行旁边的空间则无法做到这一点。 还有研究提出了构建内存内部异构计算的方案,如CENT架构完全从CXL系统中移除了GPU,HALO则按阶段分配工作,将计算密集的预填充分配给计算内存,将内存密集的解码分配给计算DRAM。
这些研究方向都在不断推进PIM技术的实用化进程,但真正可量产的银行级设备仍然更偏向GEMV优化。 从时间线来看,JEDEC在2025年7月发布了基础LPDDR6标准JESD209-6。2026年4月,JEDEC表示JC-42.6委员会即将完成独立的LPDDR6 PIM标准制定,同时还包括512GB密度、更窄的每管芯x6接口以及SOCAMM2模块标准等。JEDEC尚未公布最终发布日期。三星的路线图将LPDDR5X-PIM定位为当前可出货的产品,而LPDDR6-PIM则正在向完成的标准靠拢。 目前的状态是三星已拥有可工作的芯片,JEDEC拥有未完成的标准,而开源运行时仍然缺乏软件栈支持。
加速器软件往往比硬件滞后一年或更长时间才能成熟,而PIM的集成难度更是超过了简单的添加另一个计算后端,因为它需要深入内核的页面分配器并回溯整个量化流程。PIM触及的是计算机系统最底层的软件层次。 这项技术的采用将取决于是否有人愿意投入资源构建感知银行布局的分配器和量化流程的重新量化路径。最可能的实现路径是三星或SK海力士资助的运行时分支开发,类似于早期供应商GPU后端的发展模式,先在分支版本中实现功能,然后再逐步向上游移动。 从更宏观的角度来看,面对内存墙问题,行业已有的应对方案包括通过更宽的总线、更多内存通道、HBM堆叠或大型统一内存SoC来购买带宽。但每种方案都会带来额外的功耗、成本和封装复杂性。
PIM通过在DRAM银行旁边直接放置计算单元,为系统设计师提供了另一种在不加宽内存接口的情况下提高有效带宽的途径。这种技术路径的独特价值在于它能够唤醒那些原本沉睡在DRAM芯片内部但从未被利用的带宽资源。 三星展示的三倍性能提升虽然是vendor benchmark,但其象征意义更为深远。614GB/s的内部带宽加上16GB封装容量所代表的可能性,远比这个单一测试数字更有价值。未来的技术演进可能会将多token预测与PIM结合使用,两种技术虽然都以减少权重读取成本为目标,但作用机制不同。多token预测通过一次权重读取分摊到多个被接受的token上来降低成本,而PIM则是让每次剩余的权重读取变得更快。
在当前可购买的硬件上,对于拥有准确草稿头的模型来说,多token预测可能会提供更大且更经济的收益。但可以预见的是,PIM技术代表着一种根本性的架构创新,它让那些被传统处理器白白浪费的内存内部带宽重新焕发价值,为硬件设计师在软件优化技术触及天花板时提供了新的选择。这场内存内计算的革命虽然软件生态尚在襁褓之中,但其技术潜力已经足以引起整个行业的密切关注。 。