8卡RTX PRO 6000 Blackwell系统实战指南:高并发推理与70B模型微调详解
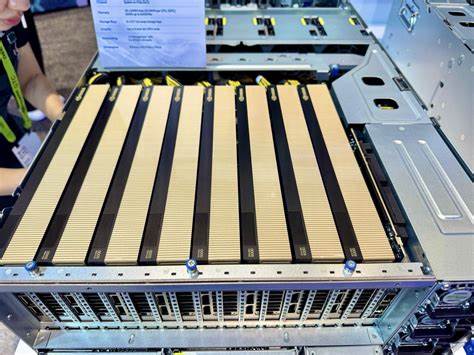
当业界还在讨论如何利用NVLink互联的高端计算卡处理超大规模语言模型时,一个更具性价比的方案正在悄然崛起。基于八块NVIDIA RTX PRO 6000 Blackwell加速卡与AMD EPYC 9555处理器构建的异构计算系统,凭借其独特的架构优势,正在重新定义高密度AI推理与轻量级模型训练的边界。这套平台拥有总计768GB的GDDR7显存容量,配合64核心128线程的Zen 5架构处理器,为企业级用户提供了前所未有的并发处理能力。本文将深入剖析这一系统的技术特性、适用场景以及最佳实践策略,帮助读者理解为何在高并发推理与多模型服务领域,这套基于PCIe总线的解决方案往往比那些价格数倍于己的NVLink系统更具实用价值。 理解这套系统的能力边界,首先要认清其核心定位。虽然768GB的聚合显存足以容纳部分超大参数模型的分片部署,但将Llama-3.1 405B或DeepSeek-R1 671B这样的巨型模型强行跨卡分片,会导致严重的通信延迟问题。

PCIe Gen 5 x16接口的单向带宽为64GB/s,双向可达128GB/s,相比NVLink 5提供的900GB/s单向带宽,存在约十四倍的差距。这种带宽鸿沟意味着,当模型状态需要在多个GPU之间频繁同步时,PCIe总线的通信开销将成为性能瓶颈,使得原本设计为并行计算的分片策略反而拖累整体吞吐量。因此,明智的选择是将这套平台用于那些天然适合独立并发执行的 workloads,而非试图用它替代专业的数据中心计算集群。 PCIe Gen 5与NVLink的技术代差,实际上反映了两种截然不同的设计哲学。NVLink专为需要紧密耦合的模型并行场景而生,其1.0至2.0微秒的AllReduce延迟使得张量并行能够高效运行。然而,这种极致性能的背后是高昂的硬件成本和严格的环境要求。
相比之下,PCIe接口的12至25微秒延迟虽然较高,但已经足以支撑起绝大多数高并发推理任务。更重要的是,当我们将目光从单一模型的极致性能转向多模型并行服务时,这套系统的优势便开始显现。八个独立的GPU实例各自拥有完整的96GB显存空间,可以同时运行八个互不干扰的推理任务,这种并行模式完全绕开了跨卡通信的瓶颈,实现了真正的线性扩展。 在单卡推理场景中,RTX PRO 6000的96GB GDDR7显存展现出了令人印象深刻的容纳能力。以Qwen3.8-27B模型为例,当采用FP8量化格式时,权重仅占用约27GB显存,剩余的约59.4GB空间可用于KV缓存管理。在这种配置下,单卡能够支持约287个并发的4K上下文会话,整个八卡节点则可容纳超过两千个并发连接。

值得注意的是,KV缓存的精度选择对系统容量有着显著影响。将KV缓存从FP8升级至BF16格式虽然会损失约一半的存储效率,但能够获得更精确的注意力计算,对于那些对输出质量要求极高的应用场景而言,这一权衡往往是值得的。类似地,当模型以BF16全精度加载时,单卡容量降至约156个并发会话,但对于需要长上下文支持的应用,系统仍能同时维持多路128K甚至256K的超长上下文流。 对于70B级别的模型,显存压力明显增大。Llama-3.3 70B以FP8格式存储需要约70GB显存,这意味着单卡仅剩约16.4GB用于KV缓存管理。在4K标准上下文下,单卡仅能支持约25个并发会话,节点级别的总容量约为200个连接。
尽管绝对数字看起来不高,但考虑到八个独立实例可以完全消除跨卡同步开销,每个实例都能以最低延迟运行,这种部署方式在延迟敏感型应用中具有独特优势。此外,70B模型的单卡服务模式使得每个GPU实例拥有完全隔离的内存池,避免了多租户场景下的资源争用问题。 多模型微服务舰队是这套平台的另一大用武之地。现代AI应用往往需要组合使用多个专业化模型,例如将代码生成模型、对话模型、工具调用模型分别部署以获得最佳效果。RTX PRO 6000的充裕显存允许在单卡上同时托管多个8B级别的模型。以三个Llama-3.1 8B模型堆叠部署为例,每个模型在FP8格式下仅占用约8GB显存,总计24GB,剩余的62.4GB空间可支撑约244个并发4K会话。
理论上,单节点可以运行24至32个独立的8B微服务端点,而对于更大容量的32B模型,系统则可支持8个专业化的专用实例。这种密度的微服务部署,使得单一4U服务器能够替代传统方案中需要数十台机器的集群,大幅降低了基础设施复杂度和运营成本。 微服务舰队配置下,AMD EPYC 9555处理器的12通道DDR5内存子系统发挥了关键作用。该处理器可配置高达1.15TB的系统内存,为KV缓存预热、向量数据库缓冲以及异步数据加载提供了充足的空间。虽然将动态KV缓存分页至主机内存会导致严重的延迟抖动,但在推理过程中,主机内存非常适合用于前缀缓存管理、RAG系统的向量检索缓冲以及模型权重的预加载准备。64个Zen 5核心则负责处理tokenization、JSON语法校验、embedding生成以及请求路由等CPU密集型任务,这些工作负载在传统架构中往往成为GPU的等待瓶颈,而充足的CPU资源确保了数据流的顺畅运转。
Fine-tuning是这套平台的另一个强项。通过PyTorch FSDP或DeepSpeed ZeRO-3框架,系统可以将梯度通信与反向计算重叠执行,从而充分利用PCIe的带宽资源进行参数分片。768GB的聚合显存足以容纳70B模型的权重与梯度状态,而AdamW优化器的动量状态则可卸载至主机内存。完整的70B模型微调需要约840GB的优化器状态,这意味着系统需要配置至少1.15TB的DDR5内存,通常通过12条96GB DIMM实现。在这种配置下,PCIe总线需要承载每卡64GB/s的数据传输,八卡总计512GB/s的通信需求约占EPYC 9555主机DDR5带宽的83%至89%,使得内存带宽成为与PCIe并列的性能约束因素。尽管如此,相比需要多节点云计算集群的传统方案,这种单节点本地微调能力已经代表了显著的成本效率提升。
对于追求迭代速度的团队,QLoRA量化微调提供了另一条可行路径。在这种模式下,4-bit量化的基础模型在各数据并行进程间复制,仅需交换适配器层的梯度。由于梯度通信量大幅减少,PCIe开销降至最低,系统可以采用更大的全局批处理规模,通常达到128至256的量级。这种方法特别适合需要快速将通用模型适配至特定领域的应用场景,例如将Llama系列模型针对客服、医疗或法律文档进行领域微调,而无需承担全参数训练的内存和时间成本。 在强化学习人类反馈对齐场景中,这套平台同样展现出了独特价值。RLHF和DPO训练通常需要同时运行Actor模型进行 rollout 生成和Critic模型进行奖励评估,两者都需要大量的显存支持。
传统的分布式训练方案需要跨节点协调网络通信,而在这套单节点系统中,Actor和Critic可以共置在768GB的聚合显存池中,完全消除了多节点网络延迟和带宽限制带来的训练不稳定性问题。这种本地化的RLHF pipeline特别适合那些需要快速迭代对齐策略但又不愿依赖云端训练资源的研究团队。 生产环境的吞吐量规划需要根据具体 workload 类型进行差异化配置。孤立式70B服务采用八个独立实例部署,每个实例运行在单一GPU上,这种配置的优势在于零跨卡通信开销和完全隔离的内存空间,适合对延迟敏感且并发量适中的应用场景。对于需要更大KV缓存空间的任务,可以采用四组双GPU配对的方式,以张量并行度为2的模式运行70B模型,这种配置能够在保持较低通信开销的同时,将单实例的KV缓存容量翻倍,聚合吞吐量可达1500至3200 token每秒。 多模型8B至14B舰队则代表了最高的吞吐量密度。
在这种配置下,8个独立实例各自运行一个中等规模模型,聚合吞吐量可达10000至18000 token每秒以上,且随着并发数增加呈现完美的线性扩展特性,没有任何同步等待带来的效率损失。对于视频生成等扩散模型任务,八个独立的GPU实例可以分别处理8路1080P或4K分辨率的视频生成,每卡充裕的96GB显存足以支持不依赖tiling的完整潜在空间生成,显著提升了生成质量和效率。 Agentic系统中的推理工作负载同样适合这种架构部署。现代AI代理通常需要同时运行多个推理路径以探索不同的行动序列,或者并行执行多个子任务。将八个独立的推理worker部署在同一节点上,可以实现分支执行的真正并行,消除了跨服务器通信带来的延迟不确定性。这种配置对于需要低延迟响应的交互式代理应用尤为重要,例如实时对话系统或需要快速工具调用的自动化工作流。
这套平台的成功部署需要注意几个关键的技术细节。首先是散热与供电管理,八块TDP数百瓦的加速卡在4U机箱中密集部署,对散热系统提出了极高要求。建议采用液冷或高风量强制散热方案,确保GPU在持续高负载下维持稳定的工作温度。其次是软件栈的优化配置,vLLM作为当前最高效的推理引擎之一,已经针对Blackwell架构进行了深度优化,建议使用最新版本以获得最佳的显存分配效率和吞吐量表现。 在存储层面,虽然推理工作负载本身对存储带宽的需求相对较低,但模型加载、大规模数据集访问以及检查点保存等操作仍需要可靠的存储支持。建议配置NVMe SSD作为本地缓存盘,并利用主机内存作为临时数据缓冲区,以最大化数据准备阶段的效率。
网络层面,万兆或更高速的以太网络对于接收客户端请求和与其他服务节点交换数据至关重要,特别是在构建分布式微服务架构时。 从成本效益角度分析,这套基于PCIe总线的8卡系统代表了独特的市场定位。它不适合作为超大规模语言模型训练的主力平台,这一定位由配备NVLink的专业计算集群牢牢占据。然而,在高密度推理服务、多模型微服务托管以及中小规模模型微调等领域,这套系统的性价比优势非常明显。企业用户可以用远低于NVLink集群的投入,获得稳定可靠的多租户服务能力,同时保持灵活的扩展空间。 对于正在评估AI基础设施选型的技术决策者,理解 workloads 特性与硬件架构的匹配关系至关重要。
将正确的工作负载部署在正确的平台上,才能实现资源的最优利用。这套8卡RTX PRO 6000 Blackwell系统,以其独特的高并发处理能力、充裕的本地显存资源以及合理的部署成本,为企业级AI应用提供了一个极具竞争力的选择。随着生成式AI应用场景的持续扩展,相信这类专注于高密度并发处理能力的平台将迎来更广阔的应用前景。 。