DuckDB 异步I/O:突破远程数据查询性能瓶颈的革命性技术
深入解析DuckDB 2.0 异步I/O架构,如何通过并发读取与线程池优化,将远程数据湖查询速度提升3-20倍,并探索其在CSV、Parquet等格式的实际应用与性能测试结果。
在数据处理领域,查询引擎的性能不仅取决于CPU计算能力,更依赖于数据读取的效率。传统数据库系统在处理本地文件时表现优异,但随着云原生架构的兴起,越来越多的查询需要从远程存储(如AWS S3)读取数据。此时,同步I/O模式的弊端暴露无遗:线程因等待数据而阻塞,网络带宽利用率低下,查询性能严重受限。面对这一挑战,DuckDB 2.0(预计2026年秋季发布)推出了革命性的异步I/O技术,通过并发读取与智能线程池调度,将远程数据查询性能提升至前所未有的高度。**从同步到异步:I/O模式的根本转变**在DuckDB的发展早期,其主要应用场景是本地数据查询。由于数据文件存储在SSD上,系统可以通过分区(如Parquet文件的行组或CSV文件的固定缓冲区)实现高效的同步读取。

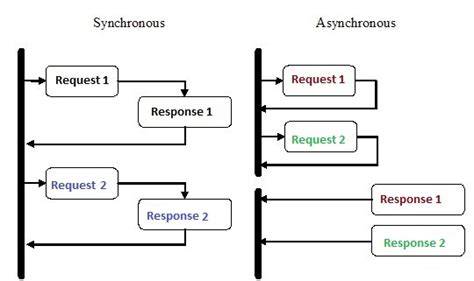
此时,查询瓶颈主要出现在计算密集型操作(如连接、聚合、子查询)而非数据读取。然而,随着DuckDB在云原生场景中的广泛应用,特别是DuckLake等数据湖解决方案的推出,远程存储成为常态。在EC2实例与S3存储桶位于同一区域的典型架构中,网络延迟和带宽成为制约性能的关键因素。传统同步I/O模式下,单个线程发起读取请求后必须等待数据完全传输才能继续执行后续操作。例如,执行简单的Parquet文件查询时,系统会将文件分解为多个行组,每个行组包含若干读取任务。线程在等待网络响应期间处于空闲状态,无法进行解码、聚合等实际工作。
这种模式导致网络带宽利用率极低,通常仅能达到理论峰值的20%左右。在极端情况下,线程可能将90%的时间浪费在等待I/O上,而非有效计算。异步I/O技术通过解耦数据读取与处理流程,彻底改变了这一局面。在DuckDB 2.0的实现中,系统引入了两个独立的线程池:1. **常规线程池(REGULAR)**:由与CPU核心数量相等的线程组成,负责执行实际的计算任务(如解码、连接、聚合)。这些线程在空闲时也可参与I/O操作,但其主要职责是数据处理。2. **异步线程池(ASYNC)**:专门用于执行阻塞性I/O操作的线程集合。

由于远程存储访问(如HTTP请求)通常需要等待网络响应,这些线程的CPU利用率极低。为最大化并发度,系统默认配置异步线程数量为CPU核心数的4倍,上限为256个线程。这种设计确保在网络延迟较高的场景下,仍能保持足够的并发读取请求。**读取前瞻机制:让数据提前到达**异步I/O的核心优势在于读取前瞻(Read-Ahead)机制。传统同步模式下,系统仅在需要数据时才发起读取请求;而异步模式则通过提前调度读取任务,确保数据在计算线程需要时已准备就绪。具体实现中,系统将查询任务分解为多个独立的作业(Job),每个作业对应文件的一个逻辑单元(如Parquet的一个行组或CSV的一个扫描边界)。
当常规线程开始处理当前作业时,异步线程已提前开始读取后续作业的数据。这种流水线式的处理方式使得I/O操作与计算操作得以并行执行。例如,在Parquet文件扫描中,系统可能同时进行以下操作:- 异步线程A读取行组1的数据- 常规线程解码行组2的数据- 异步线程B读取行组3的数据通过这种方式,网络延迟被隐藏在计算过程中,从而显著提升整体吞吐量。系统还引入了内存治理机制,通过`read_ahead_depth`参数控制前瞻深度,防止因过度预读导致的内存溢出。用户可通过`SET read_ahead_depth = N;`配置前瞻深度,其中N=-1表示无限制(由内存管理器动态调节),N=0关闭前瞻功能,N>0设置固定前瞻作业数量。**Parquet与CSV:格式差异下的优化策略**异步I/O技术在不同文件格式中的实现略有差异,需针对格式特性进行优化。
对于Parquet文件,系统利用其列式存储和行组划分的特性,将每个行组视为独立的作业单元。读取任务被进一步细分为多个读取任务(Fetch Task),具体数量取决于查询的投影、过滤下推、物理列位置等因素。例如,某个查询可能需要读取行组中特定列的数据,系统会将这些列的字节范围合并为一个读取任务,以减少网络请求次数。这种按需合并策略不仅提升了并发度,还降低了小文件场景下的开销。CSV文件由于缺乏Parquet的元数据结构,处理方式更为灵活。系统将CSV文件划分为固定大小的缓冲区,每个缓冲区对应一个作业。
当扫描边界到达缓冲区末尾时,系统自动加载下一个缓冲区,确保行不被截断。由于CSV是行式存储,每次读取通常需要传输更多数据,因此异步I/O在CSV场景下的性能提升更为显著。实测数据显示,对于80.89GB的CSV文件,异步I/O将查询时间从878秒缩短至45秒,提升幅度高达20倍。**性能测试:从理论到实践的飞跃**为验证异步I/O的实际效果,DuckDB团队进行了多组对比测试,涵盖Parquet、CSV、本地磁盘等多种场景。所有测试均使用TPC-H Query 6作为基准查询,数据集规模为SF100(约6亿行)。在远程Parquet测试中,数据存储于AWS S3,查询在EC2 r7i.16xlarge实例(64 vCPU、512GB内存)上执行。
测试结果显示:- DuckDB 1.5.5(同步I/O):平均查询时间8.230秒,网络吞吐量约5Gbit/s- DuckDB 2.0(异步I/O):平均查询时间2.844秒,网络吞吐量接近25Gbit/s- 经过调优的异步I/O(设置`async_threads=48`、`http_retries=8`等参数):查询时间进一步缩短至2.227秒,网络利用率达到峰值测试还发现,同步I/O模式下,系统需要数百毫秒才能开始有效传输数据,主要用于建立连接、TLS握手和读取文件尾部元数据。异步I/O通过并发处理这些初始化步骤,将延迟降至最低。在本地磁盘测试中,数据存储于MacBook Pro的SSD上(Apple M4 Max,14核心,36GB内存)。由于SSD延迟远低于网络,异步I/O的优势有所减弱,但仍实现了约1.5倍的性能提升:- 同步I/O:1.321秒- 异步I/O:0.883秒对于小文件场景(如976个22MB的Parquet文件),异步I/O同样表现出色,查询时间从9.344秒缩短至2.945秒,提升约3倍。这表明系统能够有效并行处理多个文件,避免了文件打开和元数据读取的瓶颈。**行组大小的微妙平衡**Parquet文件的行组大小对查询性能有显著影响。
测试通过调整行组大小(从4MB到12.3GB不等),发现存在一个最优区间:- 当行组大小为70MB(306个行组)时,查询时间最短(2.11秒)- 行组数量过少(如4个行组)会导致并行度不足,查询时间延长至8.01秒- 行组数量过多(如4,886个行组)则增加调度开销,查询时间为2.74秒这一结果表明,理想的行组数量应与系统CPU核心数量相匹配,以充分利用并行处理能力。同时,过大的行组会降低查询的灵活性,而过小的行组则增加了调度和网络开销。**并发查询:多查询场景下的协同优化**在多查询并发场景中,异步I/O的优势更加明显。测试同时执行TPC-H的4个不同查询(Q1、Q6、Q9、Q18),在默认内存配置下:- DuckDB 1.5.5:平均CPU利用率仅6%,峰值带宽10.7Gbit/s,总运行时间35.8秒- DuckDB 2.0:平均CPU利用率48%,峰值带宽24.9Gbit/s,总运行时间15.6秒即使在内存限制为8GB的严苛条件下,异步I/O仍能保持25Gbit/s的网络带宽利用率,总运行时间仅24.2秒,而同步I/O为35.9秒。内存治理机制通过动态调整前瞻深度,在保证性能的同时有效控制了内存使用。**未来展望:更广泛的格式支持与技术演进**当前异步I/O技术已覆盖Parquet和CSV格式,DuckDB团队计划在后续版本中扩展至JSON和DuckDB原生格式。
对于扩展存储格式(如位于树外扩展中的格式),暂时未纳入开发计划。此外,团队正在探索Linux的io_uring异步I/O接口,该技术有望进一步降低系统调用开销,减少阻塞在I/O上的线程数量。如果实践证明其有效性,将集成至DuckDB中。io_uring通过零拷贝机制和批量处理,有望将I/O延迟降低至微秒级别,为数据库系统带来新的性能突破。**实践指南:如何在DuckDB中启用异步I/O**用户无需复杂配置即可享受异步I/O带来的性能提升。在DuckDB 2.0中,异步I/O将作为默认功能启用。
对于开发者,可通过以下方式进行调优:1. **基本配置**: sql -- 启用异步线程池(默认4倍CPU核心数) SET async_threads = 48; -- 调整HTTP重试策略(适用于S3等远程存储) SET http_retries = 8; SET http_retry_wait_ms = 50; SET http_retry_backoff = 2; ```2. **内存管理**: ```sql -- 设置前瞻深度(-1为自动调节,N为固定作业数) SET read_ahead_depth = 64; -- 限制内存使用(适用于内存受限环境) SET memory_limit = '16GB'; ```3. **格式特定优化**: 对于CSV文件,建议使用`auto_detect`选项启用自动类型推断: ```sql SELECT * FROM read_csv_auto('data.csv'); ```**结论:异步I/O重新定义远程数据查询体验**DuckDB 2.0的异步I/O技术通过并发读取、智能线程池调度和读取前瞻机制,将远程数据查询性能提升至一个新的高度。无论是处理大规模Parquet文件、CSV数据集还是小文件场景,异步I/O都能显著缩短查询时间,提升网络带宽利用率。随着云原生架构的普及,这种技术将成为数据处理领域的重要基础设施。对于数据工程师和分析师而言,异步I/O不仅意味着更快的查询速度,更代表着一种全新的数据访问范式。通过解耦I/O与计算,系统能够在复杂的云环境中保持高效运行,为实时分析和大规模数据处理提供强有力的支持。随着DuckDB生态的不断完善,我们有理由期待更多创新技术的涌现,共同推动数据处理行业的发展。
。