这篇文章分享了我在日常工作中遇到的一场性能怪异,以及最终发现的解决方案。当我第一次看到路由引擎的响应时间飙升到异常高位时,我并没有立即联想到 Redis 集群的内部机制。但随着深入地观察日志和跟踪,我发现每次看似单一的读取请求实际上被拆解成了数十个独立的 MGET 调用。正是这个细微的差异,揭示了 Redis 集群中一个名为"哈希槽"的关键概念,而这个概念此前一直被忽视着。 我们这套服务主要用于决定哪个快递员可以接收用户订单。在每笔订单的分派过程中,我们需要持续地计算大量的路径估算。

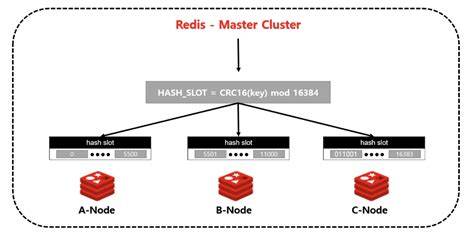
这些估算结果因为地理位置的相似性而表现出很高的重复率:不同的快递员在从用户位置到目的地的距离上往往相差无几,如果不进行任何缓存处理,那么每次请求都会重新向外部路由服务发送计算任务。这不仅浪费服务器资源,还加剧了网络延迟,最终导致整个系统的响应时间出现不可接受的波动。 起初,我尝试了一种最直接的缓存方法:将原始经纬度坐标存储在 Redis 中,并通过 H3 算法将这些坐标转换为十六进制空间标识符。缓存键的格式为 "originHex:destHex:resolution",对应的值则是路径估算时间。由于写路径需要同时写入多个键,我们选择了 MSET 命令,以期一次性完成批量写入。然而,我很快发现这种方法在分布式环境下遇到了一个意想不到的问题:Redis 集群通过哈希槽(hash slot)来实现数据分布,每个槽归属于一个特定的节点上,而 MSET 或 MGET 等支持多键操作的命令要求所有参与的键必须位于同一个槽内。
否则,Redis 客户端会被迫将每个键单独封装成独立的网络请求,最终导致原本可以并行处理的缓存操作变成串行执行,大大增加延迟。 我最初并没有意识到哈希槽的存在。直到观察到分布式追踪中显示的一条读取请求被拆解成数十个独立的 MGET 调用时,我才恍然大悟。原本一次批量读取的操作因为键的分布不均,被分解成了多次独立的操作,这正是导致高延迟的根源。了解到这一点后,我立即着手分析当前缓存键的分布模式。通过计算每个键的 Redis 哈希值(CRC16(key) mod 16384),我发现在每个请求中,键都包含一对不同的十六进制标识符,这意味着每个键几乎必然落入不同的哈希槽。

最终结果是每条写入和读取操作都只能在一个槽内完成,完全失去了批量处理的优势。 为了解决这个问题,Redis 提供了一种名为"哈希标签"(hash tag)的机制。当一个键中包含一对大括号时,Redis 只会对大括号内部的内容进行哈希计算,而忽略键的其他部分。这种方式允许我们人为地将多个原本分散的键强制映射到同一个哈希槽上,从而恢复多键操作的并行性。实践中,我们可以选择一个固定的模板,例如 "{routing:v1:%d}",其中 %d 是一个占位符。随后,我们需要为这个标签生成一个合理的整数值。
通过模仿比特币挖矿的过程,我们可以遍历 0 到无穷大的整数,逐个计算对应标签的哈希值,并将其映射到 Redis 集群中的哈希槽。只有当目标槽尚未达到容量限制时,我们才会保留这个整数。如此反复,直到为每个 Redis 节点收集到足够数量的有效标签。通过这种方式,即使数千个原本分散的缓存键,它们也能够聚拢到少数几个槽中,进而形成合法的多键命令发送给特定的节点,从而显著减少网络往返次数。 当我们成功引入哈希标签后,批量的缓存操作不再需要被拆解成上百次独立调用。在多节点环境中,每个节点只负责处理与自己相关的那部分命令,这既避免了不必要的网络开销,也充分利用了 Redis 的单线程特性,避免了队列积压导致的进一步延迟。
此外,我们还进一步优化了命令的组织方式。每次批量读取操作之前,我们会提前计算出每个键所归属的哈希槽,并按照槽进行分组。这样,当我们将整批请求拆成小块发送时,每块都只包含来自同一槽的键,确保每个节点一次只处理一个命令,避免了同节点并发请求导致的服务阻塞。这种细致的组织方式,让我们的系统得以保持高效的吞吐率,即使在高峰期也不会出现长尾延迟问题。 除了哈希标签之外,我们还遇到了另一个与缓存有效期相关的挑战。MSET 命令无法同时设置键的有效期,这迫使我们要么为每个键单独发送一个 SET 命令(爆炸式增加网络请求数量),要么先执行 MSET,再对所有键统一调用 EXPIRE。
这样做虽然简单,但会在两步操作之间留下一个潜在的窗口:如果 Redis 节点在这段时间内发生重启,缓存可能会永久丢失。因此,我们转向使用 Redis 的 EVAL 脚本。通俗地说,我们可以将一组键的写入操作封装成一个 Lua 脚本,在脚本内部一次性完成键的设置和过期时间的设定。这样既避免了多轮网络交互,又确保了缓存操作的原子性。我们最终采用这种方式来管理缓存的有效期,消除了安全隐患并简化了代码结构。 缓存数据的格式也是一个值得关注的细节。
起初,我们选择 JSON 作为存储格式,因为这符合团队的惯例且语法简洁。然而,在我们持续地处理大量数据时,发现 JSON 格式的解析和序列化消耗了相当多的 CPU 资源,从而进一步拖累了系统的整体性能。通过改用逗号分隔的轻量级文本格式,我们成功降低了服务器的 CPU 负载,加速了缓存读写的速度。事实证明, seemingly 不经意的细节选择,往往会直接影响系统的最终表现。 整个过程让我体会到一个重要的编程原则:我们必须时刻保持好奇心和批判性思维,而不仅仅是简单地照搬现有的解决方案。每个遇到的问题背后,都隐藏着一个更深层次的原因。
从初次发现高延迟问题,到最终找到哈希标签解决方案,我不断询问自己,为什么要在每个键上加入大括号?为什么要遍历整数序列来生成标签?这些问题推动我深入理解了 Redis 集群的数据分布机制,理解了为什么多键操作必须遵守槽内一致性规则,也理解了如何通过简单的机制改造原有架构,以适应业务需求。 与此同时,这次经历也让我重新审视了自己对性能优化的理解。我的团队成员一直强调罗伯特·皮克(Rob Pike)的五条编程法则,尤其是在规则 2(测量)和规则 3(复杂算法在小数据集上表现不佳)上的强调。在发现缓存问题之前,我已经通过仪器监测到了与路由服务交互是最大的瓶颈,我也认为一个简单的缓存方案就能解决问题。然而,随着系统的不断扩展,我发现缓存操作本身已经成为主要吞吐量的制约因素,而我最初的简单方案显然已无法满足需求。这时,我意识到必须采用更成熟、更"复杂"的算法来优化性能,包括多键分组、槽内分配和标签生成策略。
为了验证这些方案的有效性,我专门编写了一个基准测试平台。这个平台能够模拟真实业务负载,并提供对批量缓存操作的详细统计指标。通过调整平台中的不同参数,我得以比较新老方案在延迟、吞吐量和资源消耗等方面的表现。基准测试结果明确地证明了哈希标签方法能够将平均延迟从数千毫秒降到数百毫秒,同时大幅提升了每秒处理请求的数量。这个事实极大地增强了团队对这一方案的信心,也让我们有勇气将其部署到生产环境中。 回顾整个项目历程,如果让我从头再来,我会首先投入时间和精力构建这样一个基准测试平台,而不是在问题出现后再修复。
时代在不断进步,自动化的测试工具和持续集成管道已经能够在短短几分钟内提供可靠的性能数据,因此再也没有理由去冒着系统崩溃的风险进行"粗放式"的开发。这种以基准测试为导向的开发方式,不仅能够有效提升代码质量,还能显著缩短问题排查的时间,是我在最近几家公司实践中得出的宝贵经验。 通过这次项目,我深刻体会到一个永恒的道理:好的软件工程不仅仅是写出符合语法规范的代码,更需要对问题有深思熟虑的洞察,对性能有持续的关注,以及对已有的技术细节保持质疑的精神。正是对 Redis 哈希槽这个"隐秘"机制的发现和利用,才让原本效率低下的缓存层彻底焕发了活力。 如果您也在为多键 Redis 操作的性能问题而苦恼,或者想了解更多关于哈希标签在实际工程中的应用技巧,不妨参考本文的实践经验,并结合您的业务场景进行调整。希望本文能够为您带来一些启发,也祝愿您在未来的开发道路上少走弯路,多一些高效与简洁。
通过这次经历,我更加坚信,持续的学习和不断的自我批评是技术成长的关键。我们应该永远保持好奇心,去探究那些看似不起眼的细节背后所蕴含的原理,正如 Redis 哈希槽这个不起眼的概念,最终帮助我们解决了严重的性能瓶颈。正是这种精神,驱使我在不断探索中进步,也将引领我走向更高的成就。 。