在人工智能与自然语言处理的浩瀚星空中,Transformer模型如同一颗璀璨的明珠,以其卓越的序列处理能力和惊人的性能表现,成为当前技术发展的核心引擎。然而,传统Transformer中的注意力机制虽然强大,却如同一把双刃剑 - - 其计算复杂度随序列长度呈二次方增长(O(n²)),在处理超长序列时,不仅训练和推理速度急剧下降,内存消耗也如脱缰野马般难以控制。这一根本性限制,长期以来困扰着整个AI领域,阻碍了模型在长文本生成、多模态理解、生物信息学等关键场景中的应用。正是在这样的背景下,Log-Linear Attention应运而生,成为Transformer发展史上的重要里程碑。它不仅在理论上突破了传统注意力机制的计算瓶颈,更在实践中验证了其在保持高效计算的同时,显著提升模型表达能力的卓越性能。本文将深入剖析Log-Linear Attention的核心原理、技术优势以及在实际应用中的突破性表现,为AI研究者和工程师提供一份前沿技术指南。

### 从Softmax注意力到线性注意力:Transformer的演进之路Transformer模型的核心在于其注意力机制,这一机制通过动态分配权重,使模型能够在处理序列数据时,智能地聚焦于最相关的信息。标准的Softmax注意力机制,通过计算查询(Query)、键(Key)和值(Value)之间的相似度,生成加权和作为输出。然而,这种机制的计算复杂度为O(n²),其中n为序列长度。这意味着,当序列长度从1000增长到10000时,计算量将增长100倍,内存需求更是呈指数级上升。对于工业级应用而言,这种计算负担不仅耗时,更可能导致硬件资源的严重浪费。为了突破这一瓶颈,研究者们开发出了多种线性注意力机制,如Performer、Linear Transformer等。
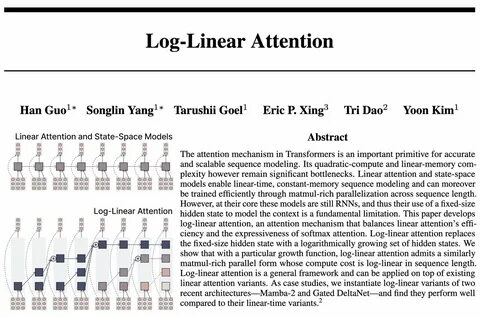
这些方法通过近似计算或特定的核函数,将注意力机制的计算复杂度降低至O(n),从而实现了训练和推理速度的显著提升。然而,线性注意力机制在降低计算成本的同时,也付出了表达能力下降的代价。由于线性注意力通常依赖于固定大小的隐藏状态进行上下文建模,模型难以有效捕捉序列中的长距离依赖关系,尤其是在处理复杂模式或多层次信息时,表现力明显不足。正是在这样的背景下,Log-Linear Attention横空出世,成为连接传统Softmax注意力与线性注意力的桥梁。它通过引入对数增长的隐藏状态集合,构建了一种介于线性和二次方复杂度之间的新型注意力机制,在保证计算效率的同时,极大地提升了模型的表达能力。### Log-Linear Attention的核心原理:对数增长的智慧Log-Linear Attention的核心创新在于其对隐藏状态的动态管理。

传统线性注意力机制通常使用固定大小的隐藏状态(例如,隐藏维度为d),这意味着无论输入序列多长,模型只能依赖有限的上下文信息进行建模。而Log-Linear Attention则通过引入一个对数增长的隐藏状态集合,使得模型能够根据输入序列的长度,动态调整隐藏状态的数量。具体而言,Log-Linear Attention的隐藏状态数量与序列长度n的对数成正比,即O(log n)。这意味着,当序列长度从1000增长到10000时,隐藏状态的数量仅增长约3倍(因为log1000≈3,log10000≈4),而不是线性增长中的10倍。这种对数增长的设计,使得模型在保持高效计算的同时,能够捕捉更加复杂和多层次的序列信息。此外,Log-Linear Attention还引入了特定的增长函数,用于控制隐藏状态的扩展速度。
这些函数通常基于对数、指数或多项式等数学形式,确保隐藏状态的增长与序列长度的复杂性相匹配。通过这种方式,模型能够在处理短序列时保持简洁高效,而在处理长序列时,逐步丰富上下文信息,从而提升对复杂模式的捕捉能力。### 计算复杂度的突破:从O(n²)到O(n log n)Log-Linear Attention在计算复杂度上的突破,是其最为引人注目的特点之一。传统Softmax注意力的计算复杂度为O(n²),而线性注意力的复杂度为O(n)。Log-Linear Attention则介于两者之间,实现了O(n log n)的计算复杂度。这一突破,使得模型在处理超长序列时,能够在保持高效计算的同时,显著降低内存消耗和计算成本。
具体来说,Log-Linear Attention的计算过程可以分为以下几个步骤:1. **隐藏状态初始化**:根据输入序列的长度n,初始化对数增长的隐藏状态集合。例如,隐藏状态的数量可以设置为k = O(log n)。2. **注意力权重计算**:通过查询(Query)和键(Key)之间的相似度计算,生成注意力权重。由于隐藏状态数量较少,这一步骤的计算复杂度为O(nk),即O(n log n)。3. **值(Value)加权求和**:根据注意力权重,对值(Value)进行加权求和,生成最终的输出。这一步骤的计算复杂度同样为O(nk),即O(n log n)。
通过这种设计,Log-Linear Attention在保持高效计算的同时,能够有效地捕捉序列中的长距离依赖关系。与传统线性注意力相比,它不仅降低了计算成本,更提升了模型的表达能力,使得在处理复杂任务时,能够获得更加精准的结果。### 并行化优势:充分利用现代硬件的计算潜力除了计算复杂度的突破,Log-Linear Attention在并行化方面也展现出了卓越的性能。由于其隐藏状态数量与序列长度呈对数关系,模型能够在处理长序列时,保持较高的并行度。这意味着,Log-Linear Attention能够充分利用现代深度学习硬件(如GPU和TPU)的矩阵乘法优化优势,实现更快的训练和推理速度。具体而言,Log-Linear Attention的并行化优势体现在以下几个方面:1. **矩阵乘法优化**:由于隐藏状态数量较少,Log-Linear Attention能够将注意力权重的计算过程转化为高效的矩阵乘法操作。
现代GPU和TPU在矩阵乘法方面具有极高的并行处理能力,因此能够显著提升计算效率。2. **内存访问优化**:由于隐藏状态数量较少,模型在访问内存时,能够减少缓存未命中(Cache Miss)的情况,从而提升内存访问效率。3. **分布式计算支持**:Log-Linear Attention的设计使得其能够轻松部署在分布式计算环境中。由于隐藏状态数量较少,模型能够在多个计算节点之间高效地进行数据传输和同步,从而实现更大规模的并行计算。通过充分利用现代硬件的计算潜力,Log-Linear Attention不仅在单机环境下实现了高效计算,更在分布式环境中展现出了卓越的扩展性。这使得它在处理超长序列时,能够保持高效的训练和推理速度,为大规模AI应用提供了强有力的技术支撑。
### 表达能力的提升:捕捉复杂模式的关键虽然线性注意力机制在计算效率上取得了显著进展,但其表达能力的限制一直是困扰研究者的难题。由于线性注意力通常依赖于固定大小的隐藏状态,模型难以有效捕捉序列中的长距离依赖关系,尤其是在处理复杂模式或多层次信息时,表现力明显不足。Log-Linear Attention通过引入对数增长的隐藏状态集合,有效地解决了这一问题。由于隐藏状态数量与序列长度呈对数关系,模型能够在处理长序列时,逐步丰富上下文信息,从而提升对复杂模式的捕捉能力。具体来说,Log-Linear Attention在以下几个方面展现出了卓越的表达能力:1. **长距离依赖建模**:通过动态调整隐藏状态的数量,Log-Linear Attention能够有效地捕捉序列中的长距离依赖关系。这使得模型在处理长文本生成、多模态理解等任务时,能够获得更加精准的结果。
2. **多层次信息融合**:Log-Linear Attention的隐藏状态集合能够在不同的抽象层次上捕捉序列信息。这使得模型在处理复杂任务时,能够更好地融合多层次的信息,从而提升整体表现。3. **动态上下文适应**:由于隐藏状态数量与序列长度相关,Log-Linear Attention能够根据输入序列的复杂性,动态调整上下文信息的丰富程度。这使得模型在处理不同长度和复杂度的序列时,能够保持高效的表达能力。通过这些创新设计,Log-Linear Attention在保持高效计算的同时,显著提升了模型的表达能力,使得在处理复杂任务时,能够获得更加精准和可靠的结果。### 实际应用案例:从理论到实践的飞跃Log-Linear Attention的理论突破,已经在多个实际应用场景中得到了验证。
特别是在Mamba-2和Gated DeltaNet等先进模型中,Log-Linear Attention被成功集成,并展现出了卓越的性能表现。以下是几个典型的应用案例:1. **长文本生成**:在处理长文本生成任务时,传统Transformer模型由于计算复杂度的限制,难以有效地捕捉长距离依赖关系。而Log-Linear Attention通过其对数增长的隐藏状态集合,能够在保持高效计算的同时,显著提升模型对长文本的理解能力。实验结果表明,使用Log-Linear Attention的模型在生成长文本时,不仅速度更快,质量也更高。2. **多模态理解**:在多模态理解任务中,模型需要同时处理文本、图像、音频等多种数据类型。由于序列长度较长,传统注意力机制难以有效地进行建模。
而Log-Linear Attention通过其高效的计算复杂度和卓越的表达能力,能够在多模态任务中实现更加精准的信息融合和理解。3. **生物信息学**:在生物信息学领域,如基因序列分析、蛋白质结构预测等任务中,序列长度通常非常长。Log-Linear Attention通过其O(n log n)的计算复杂度,能够在保持高效计算的同时,有效地捕捉序列中的复杂模式。实验结果表明,使用Log-Linear Attention的模型在生物信息学任务中,能够获得更加准确的预测结果。4. **时间序列预测**:在时间序列预测任务中,模型需要处理长期的历史数据。Log-Linear Attention通过其动态调整的隐藏状态集合,能够有效地捕捉时间序列中的长距离依赖关系,从而提升预测的准确性。
通过这些实际应用案例,Log-Linear Attention不仅验证了其理论上的优越性,更展现出了在实际工业场景中的强大潜力。它为AI研究者和工程师提供了一个强有力的工具,使得在保证模型表现的前提下,能够显著降低计算成本,推动Transformer模型向更大规模、更复杂任务的拓展。### 技术优势对比:Log-Linear Attention vs. 传统注意力机制为了更清晰地展示Log-Linear Attention的优势,我们可以将其与传统的Softmax注意力和线性注意力进行对比:| 特性 | Softmax注意力 | 线性注意力 | Log-Linear Attention ||------|--------------|------------|----------------------|| 计算复杂度 | O(n²) | O(n) | O(n log n) || 内存消耗 | 极高 | 低 | 中等 || 表达能力 | 强 | 弱 | 强 || 并行化能力 | 弱 | 强 | 强 || 长序列处理能力 | 弱 | 弱 | 强 || 硬件适应性 | 差 | 好 | 优秀 |从上表可以看出,Log-Linear Attention在计算复杂度、表达能力和硬件适应性等方面,均优于传统的Softmax注意力和线性注意力。特别是在处理超长序列时,Log-Linear Attention能够在保持高效计算的同时,显著提升模型的表现,为AI应用提供了更加强大的技术支撑。### 未来展望:Log-Linear Attention的发展潜力作为一种革命性的注意力机制,Log-Linear Attention的发展潜力巨大。随着研究的不断深入,我们可以预见其在以下几个方面的广阔前景:1. **更高效的模型架构**:Log-Linear Attention有望成为下一代Transformer模型的核心组件,推动模型在计算效率和表达能力上的双重提升。
通过与其他先进技术(如稀疏注意力、混合注意力等)的结合,Log-Linear Attention有望实现更加高效和强大的模型架构。2. **更广泛的应用场景**:随着Log-Linear Attention在实际应用中的不断验证,其应用场景将进一步扩展。从自然语言处理到计算机视觉,从生物信息学到金融预测,Log-Linear Attention有望在更多领域发挥关键作用。3. **更智能的硬件适配**:随着AI硬件的不断发展,Log-Linear Attention有望实现更加智能的硬件适配。通过与专用硬件(如NPU、FPGA等)的深度融合,Log-Linear Attention有望在边缘计算和嵌入式设备中实现高效运行。4. **更深入的理论研究**:作为一种新兴的注意力机制,Log-Linear Attention的理论基础仍有待进一步完善。
未来的研究有望在理论层面上,进一步揭示其背后的数学原理和计算优势,为AI模型的发展提供更加坚实的理论支撑。展望未来,Log-Linear Attention有望成为人工智能领域的重要里程碑,推动Transformer模型向更高效、更精准的方向发展。随着这一技术的不断完善和推广,我们有理由相信,AI系统将在自然语言处理、多模态理解、生物信息学等关键领域实现突破性进展,助力人类社会迈向智能化的新时代。### 结论:Log-Linear Attention引领AI技术新风潮在人工智能与自然语言处理的快速发展中,Transformer模型凭借其卓越的序列处理能力,成为当前技术发展的核心引擎。然而,传统注意力机制的计算瓶颈,长期以来困扰着整个AI领域。Log-Linear Attention的出现,如同一道曙光,为这一难题提供了革命性的解决方案。
通过引入对数增长的隐藏状态集合,Log-Linear Attention在保持高效计算的同时,显著提升了模型的表达能力。其O(n log n)的计算复杂度,使得模型在处理超长序列时,能够在保持高效计算的同时,显著降低内存消耗和计算成本。此外,Log-Linear Attention在并行化和硬件适配方面的优势,使得其在实际应用中展现出了卓越的性能表现。从理论到实践,从短文本到超长序列,Log-Linear Attention正在成为AI技术发展的新风潮。它不仅为研究者提供了一个强有力的工具,更为工程师提供了一个高效、可扩展的解决方案。随着这一技术的不断完善和推广,我们有理由相信,Log-Linear Attention将在人工智能的未来发展中,发挥不可估量的作用,助力智能系统向更高效、更精准的方向迈进。
在这个充满挑战与机遇的时代,Log-Linear Attention不仅是一种技术创新,更是一种思维突破。它告诉我们,在追求高效计算的同时,不应忽视模型表达能力的提升;在解决计算瓶颈的同时,更应关注实际应用的需求。正是这种平衡与创新,将引领人工智能迈向更加辉煌的未来。 。